任务状态同步系统生产设计:全链路、状态机、实时通知与高可用

真正可靠的任务看板,不是“WebSocket 一直在线”,而是:状态先成为可恢复的事实,通知只负责让事实更快到达,任何一层短暂故障后都能重新收敛到正确状态。
文件解析、AI 生成、视频转码、报表导出这类异步任务,通常会经过多个服务和步骤。用户真正关心的往往不是复杂的工作流编排,而是几个朴素问题:
- 我的新任务是否已经创建?
- 当前是等待、运行、成功,还是失败?
- 当前由哪个服务执行什么功能,不同功能的数据该如何展示?
- 哪个步骤正在执行,已经用了多久?
- 步骤失败、自动重试或执行器失联时,用户如何收到明确告知?
- 页面断线、刷新或切到后台后,会不会永远停在旧状态?
- 服务多副本、节点重启、网络闪断时,状态通知是否仍能恢复?
本文设计一套专注于任务状态、步骤状态和耗时展示的生产链路。它不负责启动下一步、不替代工作流引擎,也不把实时消息系统当数据库。
最终方案可以概括为:
Worker 状态上报
  → Task Status Service 事务校验与落库
  → 同事务写 MySQL Outbox
  → Outbox Relay 领取并调用 Centrifugo 发布
  → 用户摘要频道 + 任务详情频道
  → 前端按 version 合并
  → 恢复失败时重新读取数据库快照
一、先划清系统边界
1.1 这套系统负责什么
| 能力 | 具体职责 |
|---|---|
| 当前状态 | 保存任务与步骤当前处于哪个状态 |
| 耗时 | 保存起止时间和最终耗时,支持运行中本地计时 |
| 上报校验 | 校验任务归属、执行轮次、事件幂等和状态转换 |
| 实时展示 | 将已经提交的状态近实时通知给授权用户 |
| 断线恢复 | 短断线尝试消息恢复,恢复失败读取业务快照 |
| 多租户权限 | 只让用户订阅自己有权查看的任务 |
| 可观测性 | 监控状态写入、Outbox 积压、发布延迟、连接与恢复结果 |
1.2 它明确不负责什么
- 不决定下一步执行哪个服务;
- 不创建和调度 Worker;
- 不因为“目前已知步骤都成功”就猜测总任务成功;
- 不把频道历史当永久事件审计库;
- 不保证 Worker 已完成业务但尚未上报的状态自动出现;
- 不为页面上每秒变化的耗时发送一次消息。
如果系统需要 DAG 编排、补偿、人工审批、长周期定时器和跨服务重试,应交给 Temporal、Camunda、Argo Workflows 等编排能力。状态系统只观察和展示,不悄悄演化成第二套工作流引擎。
二、总体架构:事实层、通知层、展示层
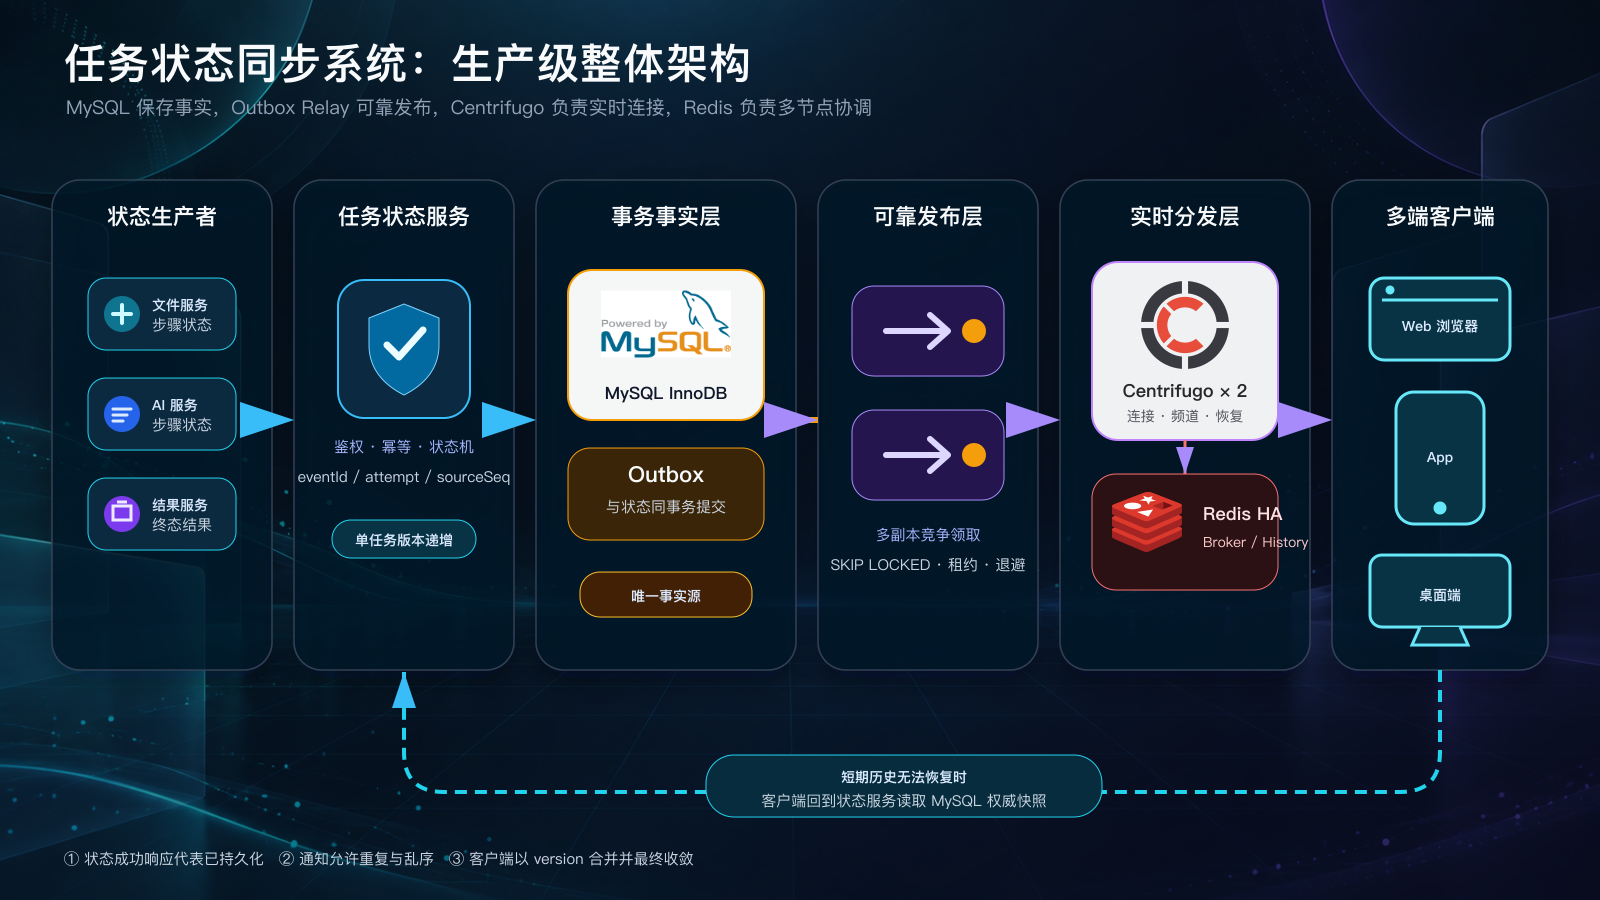
整体架构图:MySQL 保存权威事实,Centrifugo 与 Redis 负责实时分发和短期恢复;虚线表示实时链路无法证明连续时的快照兜底。
品牌标识来源:MySQL 官方 Logo 页面、Centrifugo 官方项目、Redis 官方项目。
三层的职责不能互相替代:
- MySQL 是事实源:回答“任务现在到底是什么状态”。
- Centrifugo 是通知与短期恢复层:回答“如何让在线客户端尽快知道变化”。
- 前端状态仓库是视图:按版本合并快照与推送,不能反向成为权威状态。
Centrifugo 官方也把频道历史定义为有界缓存,而不是永久消息队列;历史不足时,应用应回到自己的数据库恢复状态。参见 Stream history and recovery。
三、完整链路:从创建任务到页面显示完成
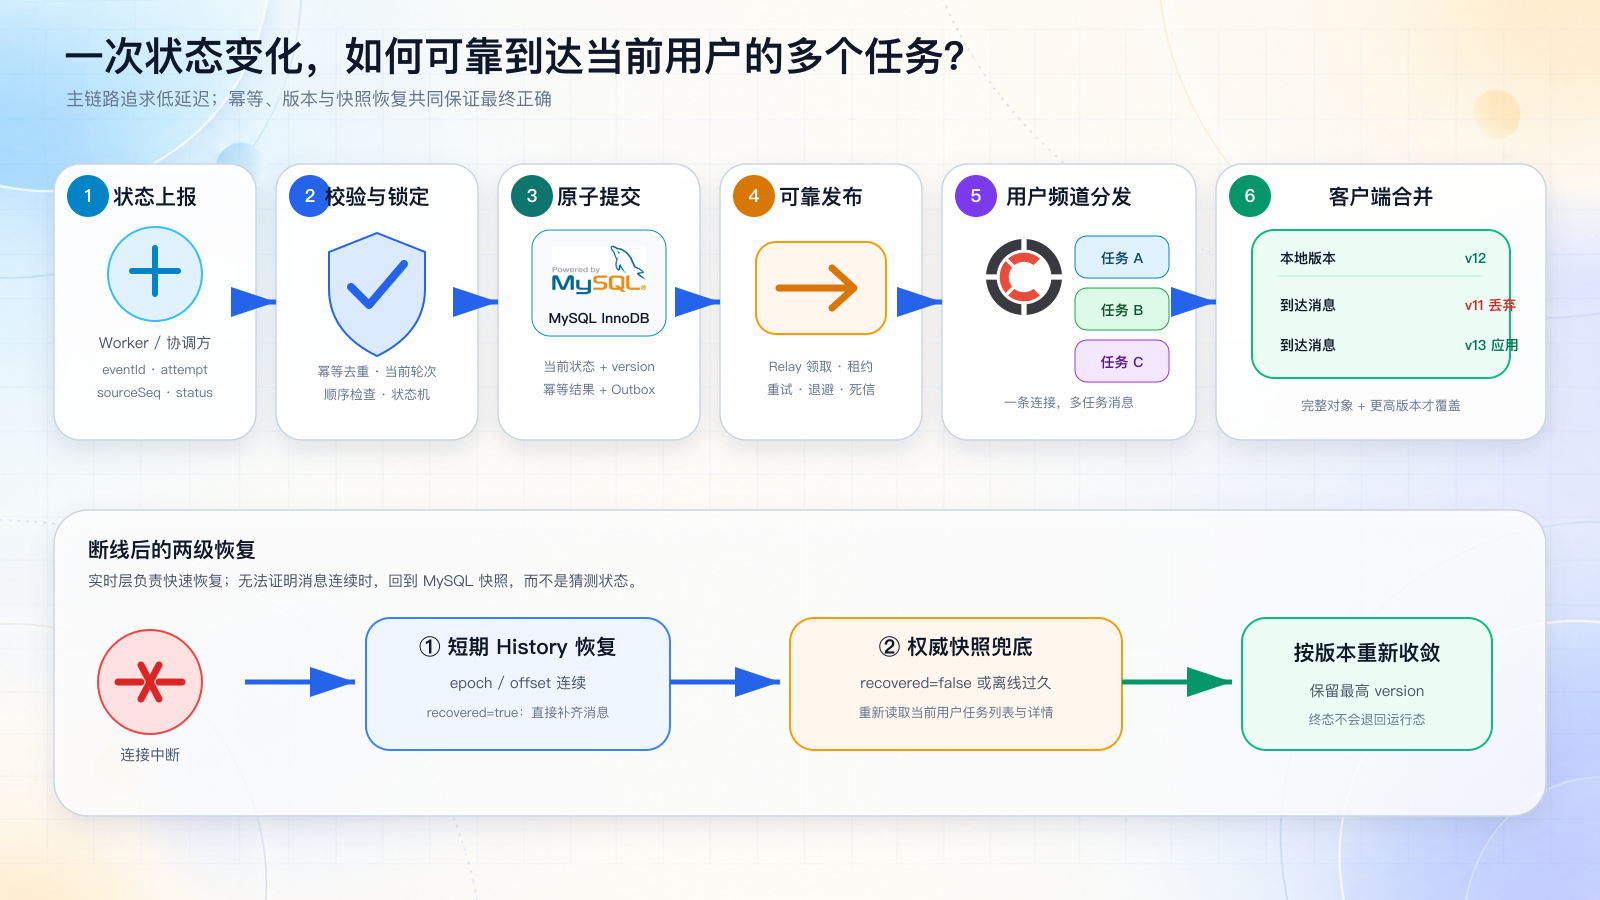
核心流程图:写入成功只代表事实已经持久化;通知可重复、可乱序,客户端以版本合并,断线后采用 History 与 MySQL 快照两级恢复。
3.1 创建任务
任务创建时就应确定任务类型、功能定义版本和每个步骤的 operationCode,不能等 Worker 上报时才临时猜测:
{
  "taskType": "DOCUMENT_PROCESS",
  "statusDefinitionVersion": 3,
  "operationDefinitionVersion": 2,
  "steps": [
    {"stepId": "01_prepare", "operationCode": "FILE.PREPARE", "producerId": "file-worker"},
    {"stepId": "02_parse", "operationCode": "DOCUMENT.PARSE", "producerId": "document-parser"},
    {"stepId": "03_store", "operationCode": "RESULT.PERSIST", "producerId": "result-service"}
  ]
}
状态服务根据功能注册表校验上述组合并落库,再为每个步骤签发受限执行上下文。后续上报只能引用这份已登记定义。
任务、已知步骤和通知命令必须在同一个事务里提交。这样不会出现下面的缺口:
task 已经提交
  → 进程崩溃
  → 还没有调用实时发布 API
  → 页面长期不知道任务存在
创建接口响应和实时消息可能乱序:推送可能先到,也可能 HTTP 响应先到。前端不能用“收到一条就追加一行”,而应以 taskId 定位对象、以 version 判断新旧。
3.2 步骤开始与完成
Worker 不直接写任务表,也不直接向浏览器发布。它向状态服务上报业务事实:
POST /internal/tasks/8a4d/events
Content-Type: application/json
Idempotency-Key: 019a-event-001
{
  "eventId": "019a-event-001",
  "taskId": "task-8a4d",
  "taskType": "DOCUMENT_PROCESS",
  "taskAttempt": 1,
  "stepId": "02_parse",
  "operationCode": "DOCUMENT.PARSE",
  "stepAttempt": 1,
  "producerId": "document-parser",
  "sourceSeq": 2,
  "eventType": "STEP_COMPLETED",
  "businessStatus": "PARSE_COMPLETED",
  "occurredAt": "2026-09-21T07:10:18Z",
  "durationMs": 18000,
  "data": {
    "schema": "document.parse.completed.v2",
    "value": {"pageCount": 36, "language": "zh-CN"}
  }
}
服务端处理顺序如下:
这些防线分别解决不同问题:
| 字段或机制 | 解决的问题 | 规则 |
|---|---|---|
executionToken | 服务越权替其他任务或功能上报 | 绑定任务、步骤、功能、轮次、生产者和允许事件类型 |
operationCode | 无法判断上报的具体功能 | 必须匹配任务创建时登记的步骤定义 |
data.schema | 不同功能数据结构混用 | 必须属于该功能和事件类型的允许 Schema |
eventId | 请求超时后的重复提交 | 同一次重试必须使用相同 ID 和相同内容 |
attempt | 上一次执行晚到并覆盖新一轮 | 旧轮次只能被忽略,不能改变当前轮次 |
sourceSeq | 同一轮次内部乱序 | 只接受比当前序号更大的状态变化 |
version | HTTP、推送和多端接收乱序 | 服务端每次有效变更递增,客户端只接收新版本 |
3.3 先统一八类标识:任务、功能、来源和事件各自独立
同一个任务可以由文档服务、AI 服务和结果服务依次或并行处理。它们不能只传一个模糊的 status,而要携带足够上下文,让状态服务知道“这是哪类任务、哪个业务功能、哪个逻辑步骤、哪一次执行、由谁产生、在该来源中的第几个事件”。
| 标识 | 生成方 | 生命周期 | 作用 |
|---|---|---|---|
taskId | Coordinator / Business API | 整个任务不变 | 聚合不同服务产生的步骤与事件 |
taskType | 业务 API / 任务模板 | 创建后不变 | 区分 DOCUMENT_PROCESS、VIDEO_EXPORT 等整类业务任务 |
stepId | 任务模板或 Coordinator | 同一逻辑步骤不变 | 标识这一次任务图中的具体步骤,如 02_parse |
operationCode | 功能注册表 / 任务模板 | 步骤定义内不变 | 标识步骤执行的稳定业务功能,如 DOCUMENT.PARSE |
attempt | Coordinator | 每次重试递增 | 隔离旧执行实例的晚到事件 |
producerId | 服务身份系统 | 服务实例或逻辑生产者 | 说明谁在上报,但不等同于业务功能 |
eventId | 事件生产服务 | 每次业务事件唯一 | HTTP 超时重试时保持相同,用于幂等 |
sourceSeq | 事件生产服务 | 在 taskId + stepId + attempt + producerId 内递增 | 判断同一生产者事件的先后顺序 |
serviceName/producerId 和 operationCode 必须分开:一个 AI 服务可能同时实现摘要、翻译和分类三个功能;同一个 DOCUMENT.PARSE 功能以后也可能从旧解析服务迁移到新解析服务。用服务名判断功能,会让扩容、重构和灰度发布直接改变业务语义。
协调方启动步骤时,应把不可缺失的执行上下文传给服务,而不是让服务自己猜:
{
  "taskId": "task-8a4d",
  "taskType": "DOCUMENT_PROCESS",
  "taskAttempt": 1,
  "stepId": "02_parse",
  "operationCode": "DOCUMENT.PARSE",
  "stepAttempt": 1,
  "producerId": "document-parser",
  "statusDefinitionVersion": 3,
  "operationDefinitionVersion": 2,
  "executionToken": "short-lived-signed-token"
}
executionToken 由状态服务或协调方签发并绑定以上字段以及允许的 eventType。服务 A 不能拿服务 B 的 Token 给另一个步骤上报,也不能把 DOCUMENT.PARSE 改成 VIDEO.TRANSCODE,更不能把 attempt=1 改成 attempt=2。状态服务以数据库中的步骤定义和 Token 为准;请求体中的功能字段只是显式自描述,必须完全匹配,不能由 Worker 自由声明。
sourceSeq 也不能只放在进程内存中:来源服务应把“业务结果、本地待上报事件、下一序号”放在自己的持久化事务或可靠 Outbox 中。服务重启后继续同一 attempt 时恢复序号;如果是一次真正的重新执行,则由 Coordinator 创建新的 stepAttempt。
3.3.1 不同功能下发不同数据:稳定信封 + 带版本的数据体
所有功能共享同一层稳定信封,客户端先依据 kind、taskType、operationCode 和版本完成路由与去重;只有 data 是功能特有内容:
{
  "kind": "task.detail",
  "schemaVersion": 1,
  "taskId": "task-8a4d",
  "taskType": "DOCUMENT_PROCESS",
  "stepId": "02_parse",
  "operationCode": "DOCUMENT.PARSE",
  "eventType": "STEP_COMPLETED",
  "taskVersion": "12",
  "stepVersion": "4",
  "data": {
    "schema": "document.parse.completed.v2",
    "value": {
      "pageCount": 36,
      "language": "zh-CN",
      "resultRef": "result://document/task-8a4d/parse-v2"
    }
  }
}
视频转码功能可以使用完全不同的数据体,但不能改变公共信封:
{
  "taskType": "VIDEO_EXPORT",
  "operationCode": "VIDEO.TRANSCODE",
  "eventType": "STEP_PROGRESS",
  "data": {
    "schema": "video.transcode.progress.v1",
    "value": {
      "frame": 18420,
      "totalFrames": 30000,
      "fps": 48.2,
      "preset": "1080p-h264"
    }
  }
}
下发数据还要按受众做投影,而不是把同一份大 JSON 广播给所有频道:
| 投影视图 | 面向对象 | 数据范围 |
|---|---|---|
USER_SUMMARY | 当前用户任务列表 | 标题、功能摘要、总状态、进度、用户可读异常,不含步骤原始结果 |
TASK_DETAIL | 已授权且正在查看详情的客户端 | 步骤、operationCode、功能特有 data、脱敏错误与操作建议 |
PROJECT_BROADCAST | 项目成员 | 聚合进度和非敏感告警,不含个人输入、结果地址和诊断信息 |
SYSTEM_BROADCAST | 所有在线用户 | 维护与服务状态,不携带任何业务任务数据 |
data.schema 必须登记在该 operationCode 允许的 Schema 列表中。兼容字段可以在同一版本追加;删除、改名或改变含义必须发布新版本。状态服务负责 JSON Schema 校验、字段白名单、大小限制和敏感字段裁剪,大结果只下发短期授权的 resultRef,不能直接塞进实时消息。
前端按功能注册渲染器,未知功能或未知 Schema 使用通用状态卡降级,不能因此丢弃任务的生命周期状态:
const renderer = operationRenderers[message.operationCode]?.[message.data?.schema];

return renderer
  ? renderer(message.data.value)
  : renderGenericTaskState(message.lifecycleStatus, message.businessStatus);
3.4 一次多服务任务如何完整传递
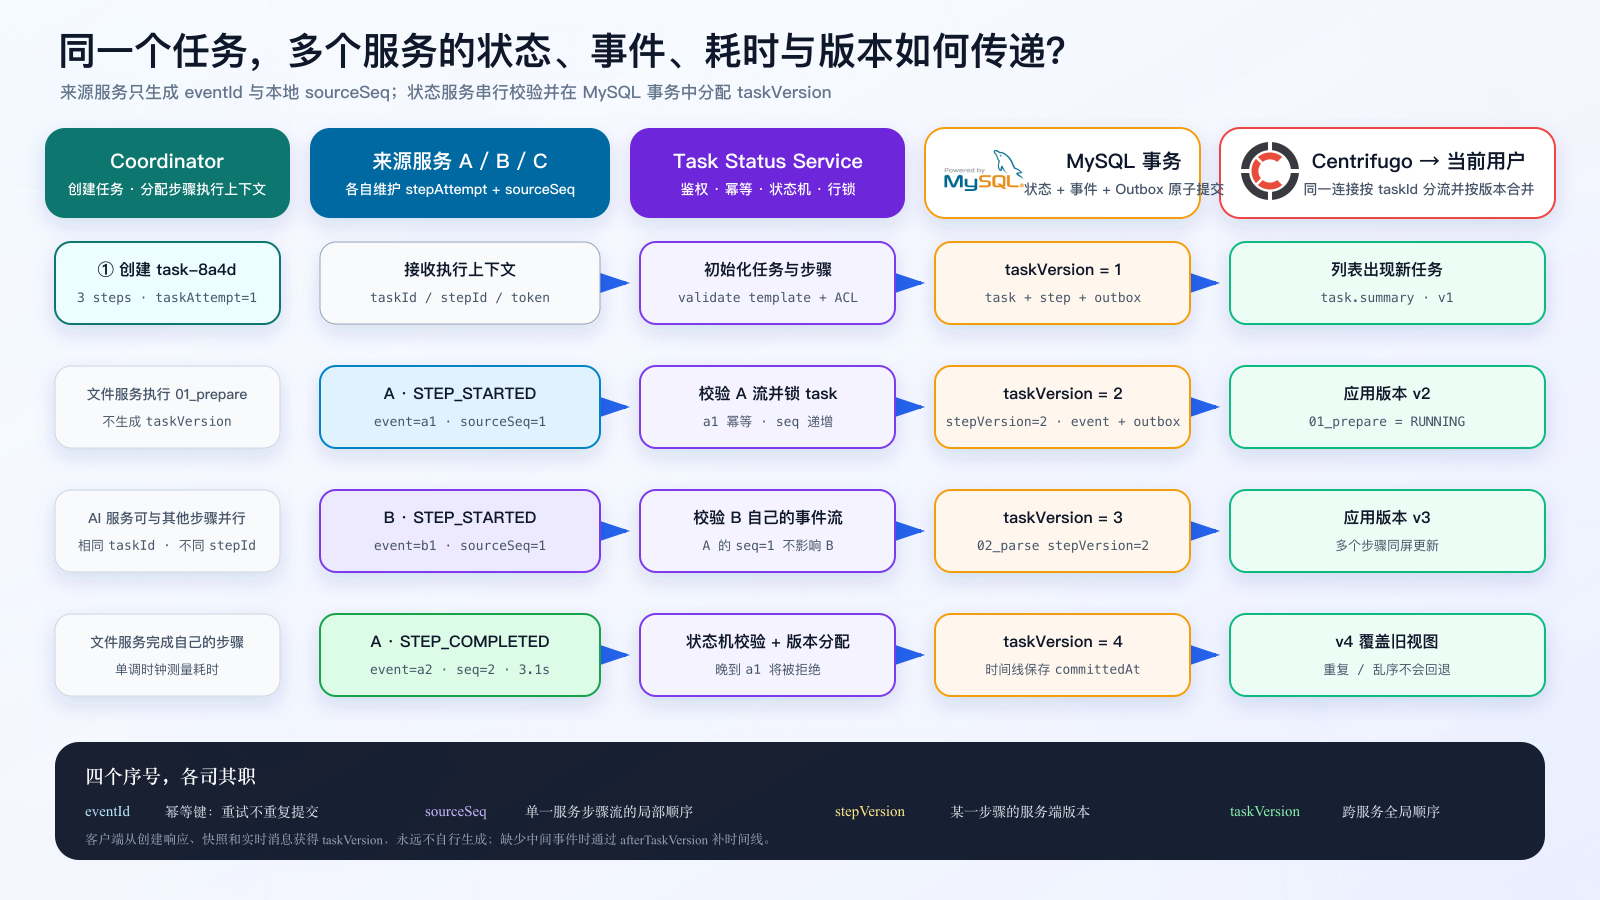
同一个 taskId 下,来源服务只维护自己的 sourceSeq;状态服务在 MySQL 事务里为所有已接受事件分配全局递增的 taskVersion。
假设任务有三个步骤:
01_prepare  FILE.PREPARE     文件服务:准备文件
02_parse    DOCUMENT.PARSE   AI 服务:解析内容
03_store    RESULT.PERSIST   结果服务:保存结果
完整过程如下:
- Coordinator 创建任务和三个步骤,状态服务写入
taskVersion=1,返回每个步骤的执行上下文; - 文件服务上报
STEP_STARTED, sourceSeq=1,状态服务接受后分配taskVersion=2; - 文件服务上报
STEP_COMPLETED, sourceSeq=2, durationMs=3100,分配taskVersion=3; - AI 服务上报
STEP_STARTED, sourceSeq=1。它是另一个stepId + producerId,序号可以重新从 1 开始,分配taskVersion=4; - AI 服务可以上报节流后的
STEP_PROGRESS,例如从 35% 到 60%,每个被接受的变化获得新taskVersion; - AI 服务完成后上报
STEP_COMPLETED, durationMs=18000,结果服务再以自己的sourceSeq上报; - Coordinator 确认所有业务收尾完成,最后上报
TASK_COMPLETED,状态服务将生命周期置为SUCCEEDED。
不同服务不共享 sourceSeq 计数器,也不直接生成 taskVersion。它们只对自己的事件流负责,状态服务负责把跨服务并发事件排成一个任务级提交顺序。
这里传递的是状态事实,不是服务间业务结果。服务 A 的文件、模型输出或索引地址仍通过现有工作流、对象存储或业务数据库交给服务 B;状态事件只携带可展示的摘要和不敏感引用。服务之间不互相转发状态,也不经浏览器中转,所有服务都独立上报给 Task Status Service。
3.5 统一事件协议:状态、进度和耗时一起传
推荐使用一个事件入口,而不是每个服务自定义一套接口:
POST /internal/v1/task-events
Authorization: Bearer <executionToken>
Idempotency-Key: evt-01JQ...
Content-Type: application/json
{
  "eventId": "evt-01JQ...",
  "taskId": "task-8a4d",
  "taskType": "DOCUMENT_PROCESS",
  "taskAttempt": 1,
  "stepId": "02_parse",
  "operationCode": "DOCUMENT.PARSE",
  "stepAttempt": 1,
  "producerId": "document-parser",
  "sourceSeq": 2,
  "eventType": "STEP_COMPLETED",
  "businessStatus": "PARSE_COMPLETED",
  "occurredAt": "2026-09-21T07:10:18.120Z",
  "durationMs": 18000,
  "progress": {
    "current": 36,
    "total": 36,
    "unit": "page"
  },
  "data": {
    "schema": "document.parse.completed.v2",
    "value": {
      "pageCount": 36,
      "language": "zh-CN",
      "resultRef": "result://document/task-8a4d/parse-v2"
    }
  }
}
taskType 表达整类任务,operationCode 表达正在执行的功能,eventType 表达这次发生了什么,businessStatus 表达业务现在处于什么阶段,四者不要混用:
eventType | 是否改变状态 | 常用字段 | 说明 |
|---|---|---|---|
STEP_STARTED | 是 | occurredAt | 第一次接受时确定 startedAt |
STEP_PROGRESS | 可选 | progress、message | 应节流、可覆盖,避免高频写入 |
STEP_COMPLETED | 是 | durationMs、data | 映射到成功生命周期 |
STEP_FAILED | 是 | durationMs、error | 错误内容先脱敏再通知客户端 |
STEP_HEARTBEAT | 否 | occurredAt | 只更新健康时间,不等同业务进度 |
STEP_HEALTH_CHANGED | 是 | health、reason | 只允许健康检查器上报,不擅自改业务终态 |
TASK_COMPLETED | 是 | durationMs | 只能由任务协调方上报 |
TASK_FAILED | 是 | error、failedStepId | 只能由任务协调方或注册的失败策略执行器上报 |
普通心跳只更新 lastHeartbeatAt,可以不增加 taskVersion、也不向客户端发布;只有健康状态从 HEALTHY 变成 STALE 或恢复时,Health Reconciler 才提交 STEP_HEALTH_CHANGED 并分配新版本。
状态服务的响应必须把最终接受结果和版本返回给调用方:
{
  "accepted": true,
  "duplicate": false,
  "stale": false,
  "taskId": "task-8a4d",
  "stepId": "02_parse",
  "operationCode": "DOCUMENT.PARSE",
  "taskVersion": "12",
  "stepVersion": "4",
  "lifecycleStatus": "RUNNING",
  "businessStatus": "PARSE_COMPLETED",
  "committedAt": "2026-09-21T07:10:18.156Z"
}
请求超时后,生产服务使用相同 eventId 和相同内容重试。状态服务从幂等表返回第一次提交的同一个 taskVersion,不能再次递增。
3.6 七种序号和版本到底分别从哪里来
这里有七种容易混淆但用途完全不同的序号或版本:
| 字段 | 产生或绑定方 | 作用范围 | 主要用途 |
|---|---|---|---|
schemaVersion | 实时协议发布方 | 消息格式 | 判断公共 JSON 信封如何解析 |
statusDefinitionVersion | 创建任务时由服务端绑定 | 任务生命周期 | 固定业务状态代码与生命周期的映射 |
operationDefinitionVersion | 创建任务时由服务端绑定 | 任务生命周期 | 固定功能、生产者、数据 Schema 与失败策略 |
data.schema | 来源服务从允许集合选择,服务端校验 | 单类功能数据 | 判断 data.value 的具体结构与兼容版本 |
sourceSeq | 来源服务生成 | 单个步骤执行流 | 拒绝同一来源的乱序旧事件 |
stepVersion | 状态服务生成 | 单个 taskId + stepId | 合并某一步骤的快照与消息 |
taskVersion | 状态服务生成 | 整个任务 | 跨多个服务建立统一提交顺序 |
版本在 MySQL 事务中分配。伪代码如下:
START TRANSACTION;

SELECT version, attempt, lifecycle_status
FROM task
WHERE id = :task_id
FOR UPDATE;

SELECT version, attempt AS step_attempt, source_seq, lifecycle_status
FROM task_step
WHERE task_id = :task_id
  AND step_id = :step_id
  AND attempt = :step_attempt
FOR UPDATE;

-- 应用进程在持有行锁时完成:
-- 1. eventId 幂等检查
-- 2. executionToken / attempt / sourceSeq / 状态机校验
-- 3. new_task_version = current_task_version + 1
-- 4. new_step_version = current_step_version + 1

UPDATE task_step
SET version = :new_step_version,
    source_seq = :source_seq,
    lifecycle_status = :step_lifecycle,
    business_status = :business_status,
    updated_at = UTC_TIMESTAMP(3)
WHERE task_id = :task_id
  AND step_id = :step_id
  AND attempt = :step_attempt;

UPDATE task
SET version = :new_task_version,
    updated_at = UTC_TIMESTAMP(3)
WHERE id = :task_id;

INSERT INTO task_event_log (..., task_version, step_version, ...)
VALUES (..., :new_task_version, :new_step_version, ...);

INSERT INTO task_outbox (..., aggregate_version, payload)
VALUES (..., :new_task_version, :complete_state_json);

COMMIT;
如果服务 A 和服务 B 同时上报,二者会竞争同一 task 行锁:先提交的事件得到 taskVersion=12,后提交的得到 taskVersion=13。这不是要求服务之间同步时钟,而是以数据库提交顺序为任务建立稳定总序。某个超热门任务可能因此成为单行热点,但普通异步任务的状态变化频率通常远低于业务数据吞吐;确有证据时再把步骤事件流与任务摘要版本拆分。
3.7 事件耗时如何得到,哪些时间可以相信
每个时间字段回答不同问题:
| 字段 | 产生位置 | 用途 |
|---|---|---|
occurredAt | 来源服务墙钟 | 展示业务事件大致发生时间 |
receivedAt | 状态服务 | 观察网络与排队延迟 |
committedAt | MySQL 事务提交附近 | 定义该版本何时成为事实 |
durationMs | 来源服务单调时钟 | 精确表示该次执行耗时 |
步骤开始时,来源服务记录单调时钟起点,并上报 STEP_STARTED;结束时用同一进程的单调时钟计算 durationMs。不要用两台机器的 finishedAt - startedAt 计算精确执行耗时,因为 NTP 偏差、休眠和时钟回拨都会污染结果。
状态服务同时保存三类耗时:
queueDurationMs = startedAt - createdAt       排队等待
runDurationMs   = Worker 上报的 durationMs    实际执行
totalDurationMs = task committed terminal - task createdAt
对于进程重启导致单调时钟起点丢失的情况,Worker 应从自己的持久化执行记录恢复;确实无法恢复时把 durationSource 标记为 WALL_CLOCK_ESTIMATE,而不是伪装成精确值。
3.8 客户端怎样获得版本和事件时间线
客户端有三种版本来源,取最大值合并:
创建任务响应:taskVersion=1
快照接口响应:taskVersion=11, 各 stepVersion
实时消息:    taskVersion=12
推荐快照接口:
GET /api/tasks/task-8a4d
GET /api/tasks/task-8a4d/events?afterTaskVersion=8&limit=100
快照返回当前完整状态,事件接口返回用于时间线展示的已提交事件。实时 task.detail 消息同时带 triggerEvent 和完整当前状态:事件区可以追加时间线,状态区只接受更高版本。
{
  "kind": "task.detail",
  "taskVersion": "12",
  "triggerEvent": {
    "eventId": "evt-01JQ...",
    "eventType": "STEP_COMPLETED",
    "stepId": "02_parse",
    "operationCode": "DOCUMENT.PARSE",
    "durationMs": 18000,
    "data": {
      "schema": "document.parse.completed.v2",
      "value": {"pageCount": 36, "language": "zh-CN"}
    },
    "committedAt": "2026-09-21T07:10:18.156Z"
  },
  "state": {
    "taskType": "DOCUMENT_PROCESS",
    "lifecycleStatus": "RUNNING",
    "businessStatus": "PARSE_COMPLETED",
    "steps": []
  }
}
如果实时消息从版本 9 直接跳到 12,不代表一定丢失了当前状态,因为消息携带完整快照;如果 UI 还要展示每一个中间事件,再调用 events?afterTaskVersion=9 补时间线。当前状态恢复和审计事件补齐是两个不同问题。
3.9 总任务完成
总任务终态应由现有业务协调方明确上报:
{
  "eventId": "019a-task-final-001",
  "taskId": "task-8a4d",
  "taskAttempt": 1,
  "producerId": "task-coordinator",
  "sourceSeq": 7,
  "eventType": "TASK_COMPLETED",
  "businessStatus": "COMPLETED",
  "durationMs": 42600
}
不要让状态服务根据“当前登记的步骤都成功”自动推导总任务成功。真实业务可能还在保存结果、生成索引、写审计记录,甚至下一步尚未登记。只有当工作流定义固定、完整且由状态服务权威管理时,才适合做状态聚合推导。
四、状态机:允许什么,拒绝什么
4.1 推荐状态集合
PENDING    已创建,尚未开始
RUNNING    正在执行
SUCCEEDED  成功终止
FAILED     失败终止
CANCELLED  取消终止
如果业务明确区分超时,可以增加 TIMED_OUT;如果只是展示“执行器可能失联”,更适合增加独立的健康字段,而不是把业务状态直接改成失败。
重试不是把同一个 attempt=1 从 FAILED 改回 RUNNING,而是由协调方创建 attempt=2。这能保留“第一次失败、第二次成功”的事实,也让晚到的第一次完成消息无法污染第二轮。
4.2 终态不可被普通事件覆盖
同一轮次中,下面的变化都应拒绝:
SUCCEEDED → RUNNING
FAILED    → SUCCEEDED
CANCELLED → RUNNING
如果业务确实需要人工纠错,不应伪装成普通 Worker 上报。应设计独立的管理员纠错命令,记录操作者、原因、旧值、新值和审计时间,并产生新的业务版本。
4.3 业务状态与健康状态分离
{
  "lifecycleStatus": "RUNNING",
  "health": "STALE",
  "lastHeartbeatAt": "2026-09-21T07:11:00Z"
}
lifecycleStatus=RUNNING:最后一个已确认的业务事实是正在运行;health=STALE:一段时间未观察到执行端心跳;- UI 显示“运行中,状态待确认”,而不是擅自改成“失败”。
连接断开、Worker 心跳超时和任务失败是三件不同的事。把它们混成一个状态,会制造大量假失败。
4.4 异常不是一个字符串:失败、失联和通知故障分别建模
异常至少分成四类,处理主体和用户文案都不同:
| 异常类型 | 谁确认 | 状态如何变化 | 用户应该看到什么 |
|---|---|---|---|
| 业务执行失败 | 当前步骤 Worker 上报 STEP_FAILED | 当前步骤 attempt 进入 FAILED | “文档解析失败:文件格式不受支持” |
| 可重试步骤失败 | Worker + Coordinator | 本 attempt 为 FAILED,任务可保持 RUNNING/RETRY_WAIT,随后创建新 attempt | “解析失败,正在进行第 2 次重试” |
| Worker 心跳超时 | Health Reconciler | health=STALE,生命周期仍保留最后已确认值 | “仍在运行,但暂时无法确认执行器状态” |
| 状态上报或实时通知故障 | 来源 Outbox / Relay / 客户端恢复机制 | 不制造业务 FAILED | “实时更新暂不可用”,恢复后读取快照 |
步骤失败时建议使用结构化错误,而不是让每个服务随意拼接一段异常栈:
{
  "eventType": "STEP_FAILED",
  "operationCode": "DOCUMENT.PARSE",
  "businessStatus": "PARSE_FAILED",
  "durationMs": 18240,
  "error": {
    "category": "BUSINESS_INPUT",
    "code": "UNSUPPORTED_FILE_FORMAT",
    "retryable": false,
    "userMessage": "暂不支持该文件格式,请转换为 PDF 后重试",
    "diagnosticsRef": "trace://01JQ7M..."
  }
}
code是稳定的机器可读错误码,驱动前端操作按钮和统计;userMessage必须可安全展示且经过长度限制、脱敏和国际化映射;diagnosticsRef只给服务端排障使用,客户端不能凭它读取日志;- 原始堆栈、SQL、对象存储地址、密钥和第三方响应不能进入实时消息。
步骤失败不一定意味着总任务立即失败。每个 operationCode 在功能定义中声明 failurePolicy:
FAIL_TASK              关键步骤失败,由 Coordinator 明确提交 TASK_FAILED
RETRY_THEN_FAIL_TASK   先创建新 attempt,耗尽重试后提交 TASK_FAILED
CONTINUE_WITH_WARNING  可选步骤失败,任务继续但 health=DEGRADED
WAIT_FOR_USER          任务保持 RUNNING,businessStatus=WAITING_USER_ACTION
状态服务可以校验策略,但总任务终态仍应由 Coordinator 或明确注册的策略执行器提交。它不能仅凭“看到一个步骤失败”猜测任务失败,因为该步骤可能可选、可补偿或正在重试。
4.5 允许业务自定义状态,但不要让它接管生命周期
不同产品需要不同的展示语义。例如文档任务可能经历“正在 OCR”“等待人工复核”,视频任务可能经历“正在渲染”“正在上传”。如果把这些值全部塞进通用状态机,每接入一个业务都要修改状态服务、客户端和告警规则。
更稳妥的模型是同时保存两套状态:
| 字段 | 示例 | 作用 |
|---|---|---|
lifecycleStatus | RUNNING | 跨业务稳定,驱动终态判断、重试、耗时和告警 |
businessStatus | WAITING_REVIEW | 业务自定义,驱动标题、说明、进度阶段和视觉呈现 |
statusDefinitionVersion | 3 | 固定本轮任务使用的状态定义,防止运行中配置漂移 |
health | STALE | 描述执行端健康,不改写已确认的业务事实 |
例如:
{
  "taskId": "8a4d",
  "lifecycleStatus": "RUNNING",
  "businessStatus": "WAITING_REVIEW",
  "statusDefinitionVersion": 3,
  "health": "HEALTHY",
  "version": "12"
}
状态上报方只能提交已经注册的 businessStatus 代码。服务端根据任务类型与定义版本解析出它对应的生命周期,并校验允许的来源状态:
DOCUMENT_PROCESS / v3

QUEUED          → lifecycle=PENDING
PARSING         → lifecycle=RUNNING
WAITING_REVIEW  → lifecycle=RUNNING
PUBLISHING      → lifecycle=RUNNING
COMPLETED       → lifecycle=SUCCEEDED, terminal=true
REJECTED        → lifecycle=FAILED,    terminal=true
调用方不能自行声明 terminal=true,也不能决定颜色、严重级别或对应的生命周期,否则一个拼错或恶意字段就可能绕过终态保护。未知业务状态应拒绝写入;旧客户端遇到暂不认识的状态时,使用 lifecycleStatus + 原始 code 降级展示,不能崩溃或误判为成功。
4.6 自定义状态注册表
状态定义可以按租户、产品和任务类型配置,但定义变更必须版本化:
CREATE TABLE task_status_definition (
  tenant_id CHAR(36) NOT NULL COMMENT '租户 ID',
  product VARCHAR(64) NOT NULL COMMENT '产品或业务域标识',
  task_type VARCHAR(128) NOT NULL COMMENT '任务类型',
  definition_version INT UNSIGNED NOT NULL COMMENT '业务状态定义版本',
  code VARCHAR(64) NOT NULL COMMENT '业务状态编码',
  display_name VARCHAR(128) NOT NULL COMMENT '默认展示名称',
  lifecycle_status VARCHAR(32) NOT NULL COMMENT '映射到的系统生命周期状态',
  terminal BOOLEAN NOT NULL DEFAULT FALSE COMMENT '该业务状态是否表示终态',
  severity VARCHAR(16) NOT NULL DEFAULT 'INFO' COMMENT '展示与告警严重级别',
  sort_order INT NOT NULL DEFAULT 0 COMMENT '同类状态的展示顺序',
  presentation JSON NULL COMMENT '颜色、图标和国际化文案键等展示元数据',
  allowed_from JSON NOT NULL COMMENT '允许迁移到当前状态的前置业务状态集合',
  enabled BOOLEAN NOT NULL DEFAULT TRUE COMMENT '状态定义是否允许用于新事件',
  PRIMARY KEY (
    tenant_id, product, task_type, definition_version, code
  )
) ENGINE=InnoDB COMMENT='租户和任务类型维度的版本化业务状态定义';
presentation 只保存诸如 colorToken、iconKey 和本地化文案键等展示元数据,不保存任意 HTML。新任务固定使用创建时的 definition_version;发布新版定义不会悄悄改变正在运行或历史任务的含义。
4.7 功能定义注册表:限制谁能上报什么、下发什么
operationCode 不能只是一个没有约束的字符串。任务模板引用版本化的功能定义,状态服务据此校验生产者、事件类型、差异化数据 Schema 和失败策略:
CREATE TABLE task_operation_definition (
  tenant_id CHAR(36) NOT NULL COMMENT '租户 ID',
  product VARCHAR(64) NOT NULL COMMENT '产品或业务域标识',
  task_type VARCHAR(128) NOT NULL COMMENT '任务类型',
  definition_version INT UNSIGNED NOT NULL COMMENT '功能定义版本',
  operation_code VARCHAR(128) NOT NULL COMMENT '稳定的业务功能编码',
  display_name VARCHAR(128) NOT NULL COMMENT '功能默认展示名称',
  producer_pattern VARCHAR(255) NOT NULL COMMENT '允许上报该功能的服务身份模式',
  allowed_event_types JSON NOT NULL COMMENT '允许该功能提交的事件类型集合',
  allowed_data_schemas JSON NOT NULL COMMENT '各事件允许使用的数据 Schema 集合',
  failure_policy VARCHAR(32) NOT NULL COMMENT '失败后的任务级处理策略',
  enabled BOOLEAN NOT NULL DEFAULT TRUE COMMENT '是否允许用于新任务',
  PRIMARY KEY (
    tenant_id, product, task_type, definition_version, operation_code
  )
) ENGINE=InnoDB COMMENT='任务功能、上报权限、数据契约与失败策略定义';
例如 DOCUMENT.PARSE 可以允许 document.parse.progress.v1 和 document.parse.completed.v2,但拒绝 video.transcode.progress.v1;producerId=document-parser 也不能给 RESULT.PERSIST 上报。新任务在创建时固定 operation_definition_version,从而避免任务运行途中配置更新导致同一事件突然改变解释方式。
五、MySQL 数据模型:当前状态、幂等和 Outbox
第一版可以使用五张运行时核心表:任务、步骤、不可变事件、事件幂等和 Outbox,外加上一节的版本化状态定义表与功能定义表。下面以 MySQL 8.0 和 InnoDB 为基线,为了便于阅读使用 CHAR(36) 保存 UUID;高写入量场景可以改为 BINARY(16),但必须统一字节序和序列化规则。
CREATE TABLE task (
  id CHAR(36) NOT NULL COMMENT '任务全局唯一 ID',
  tenant_id CHAR(36) NOT NULL COMMENT '任务所属租户 ID',
  owner_id CHAR(36) NOT NULL COMMENT '任务所属用户 ID',
  product VARCHAR(64) NOT NULL COMMENT '产品或业务域标识',
  task_type VARCHAR(128) NOT NULL COMMENT '任务类型',
  title VARCHAR(255) NOT NULL COMMENT '面向用户展示的任务标题',
  lifecycle_status VARCHAR(32) NOT NULL COMMENT '系统生命周期状态',
  business_status VARCHAR(64) NOT NULL COMMENT '业务自定义状态编码',
  status_definition_version INT UNSIGNED NOT NULL COMMENT '创建任务时绑定的业务状态定义版本',
  operation_definition_version INT UNSIGNED NOT NULL COMMENT '创建任务时绑定的功能定义版本',
  attempt INT UNSIGNED NOT NULL DEFAULT 1 COMMENT '任务级执行轮次',
  coordinator_source_seq BIGINT UNSIGNED NOT NULL DEFAULT 0 COMMENT 'Coordinator 任务级事件序号',
  version BIGINT UNSIGNED NOT NULL DEFAULT 1 COMMENT '状态服务分配的任务级单调版本',
  health VARCHAR(16) NOT NULL DEFAULT 'HEALTHY' COMMENT 'HEALTHY、DEGRADED 或 STALE',
  summary_schema VARCHAR(128) NULL COMMENT '任务列表差异化摘要数据的 Schema',
  summary_data JSON NULL COMMENT '经过白名单裁剪的任务列表差异化摘要数据',
  failure_code VARCHAR(128) NULL COMMENT '任务级稳定失败码',
  failure_message VARCHAR(512) NULL COMMENT '面向用户且已脱敏的任务失败说明',
  failed_step_id VARCHAR(128) NULL COMMENT '导致任务失败的步骤 ID',
  created_at DATETIME(3) NOT NULL COMMENT '任务创建时间',
  started_at DATETIME(3) NULL COMMENT '任务首次进入运行态的时间',
  finished_at DATETIME(3) NULL COMMENT '任务进入权威终态的时间',
  duration_ms BIGINT UNSIGNED NULL COMMENT '任务最终确认耗时,单位毫秒',
  updated_at DATETIME(3) NOT NULL COMMENT '任务状态最后提交时间',
  PRIMARY KEY (id),
  KEY task_owner_updated_idx
    (tenant_id, owner_id, updated_at DESC, id)
) ENGINE=InnoDB COMMENT='任务当前权威状态与任务级版本';

CREATE TABLE task_step (
  task_id CHAR(36) NOT NULL COMMENT '所属任务 ID',
  step_id VARCHAR(128) NOT NULL COMMENT '任务内稳定的步骤 ID',
  operation_code VARCHAR(128) NOT NULL COMMENT '该步骤执行的稳定业务功能编码',
  service_name VARCHAR(128) NOT NULL COMMENT '负责执行并上报状态的服务名',
  attempt INT UNSIGNED NOT NULL COMMENT '步骤执行轮次',
  source_seq BIGINT UNSIGNED NOT NULL DEFAULT 0 COMMENT '当前服务在本步骤轮次内的单调事件序号',
  version BIGINT UNSIGNED NOT NULL DEFAULT 1 COMMENT '状态服务分配的步骤级单调版本',
  lifecycle_status VARCHAR(32) NOT NULL COMMENT '步骤生命周期状态',
  business_status VARCHAR(64) NOT NULL COMMENT '步骤业务自定义状态编码',
  health VARCHAR(16) NOT NULL DEFAULT 'HEALTHY' COMMENT '步骤执行器的健康状态',
  last_heartbeat_at DATETIME(3) NULL COMMENT '最近一次已接受心跳时间',
  data_schema VARCHAR(128) NULL COMMENT '当前功能特有状态数据的 Schema',
  state_data JSON NULL COMMENT '经过校验和裁剪的功能特有当前状态数据',
  started_at DATETIME(3) NULL COMMENT '步骤开始时间',
  finished_at DATETIME(3) NULL COMMENT '步骤进入终态的时间',
  duration_ms BIGINT UNSIGNED NULL COMMENT '执行服务用单调时钟测得的耗时,单位毫秒',
  error_category VARCHAR(64) NULL COMMENT '业务输入、依赖、系统等错误分类',
  error_code VARCHAR(128) NULL COMMENT '稳定的机器可读错误码',
  error_message TEXT NULL COMMENT '脱敏后的错误说明',
  error_retryable BOOLEAN NULL COMMENT '该步骤失败是否允许重试',
  diagnostics_ref VARCHAR(255) NULL COMMENT '仅供服务端排障关联的诊断引用',
  updated_at DATETIME(3) NOT NULL COMMENT '步骤状态最后提交时间',
  PRIMARY KEY (task_id, step_id, attempt),
  CONSTRAINT task_step_task_fk
    FOREIGN KEY (task_id) REFERENCES task(id)
) ENGINE=InnoDB COMMENT='每个任务步骤及执行轮次的当前权威状态';

CREATE TABLE task_event_log (
  event_id CHAR(36) NOT NULL COMMENT '生产者生成的全局幂等事件 ID',
  task_id CHAR(36) NOT NULL COMMENT '所属任务 ID',
  task_version BIGINT UNSIGNED NOT NULL COMMENT '该事件提交后获得的任务级版本',
  step_id VARCHAR(128) NULL COMMENT '步骤事件对应的步骤 ID,任务级事件为空',
  operation_code VARCHAR(128) NULL COMMENT '步骤事件对应的业务功能编码',
  step_version BIGINT UNSIGNED NULL COMMENT '该事件提交后获得的步骤级版本',
  task_attempt INT UNSIGNED NOT NULL COMMENT '事件所属任务执行轮次',
  step_attempt INT UNSIGNED NULL COMMENT '事件所属步骤执行轮次',
  producer_id VARCHAR(128) NOT NULL COMMENT '事件生产服务或协调器标识',
  source_seq BIGINT UNSIGNED NOT NULL COMMENT '生产者在对应执行流内的单调序号',
  event_type VARCHAR(64) NOT NULL COMMENT '事件类型,例如 STEP_STARTED',
  lifecycle_status VARCHAR(32) NOT NULL COMMENT '事件提交后的生命周期状态',
  business_status VARCHAR(64) NOT NULL COMMENT '事件提交后的业务状态编码',
  health VARCHAR(16) NOT NULL COMMENT '事件提交后的健康状态',
  data_schema VARCHAR(128) NULL COMMENT '功能特有数据的 Schema',
  error_code VARCHAR(128) NULL COMMENT '该事件携带的稳定错误码',
  occurred_at DATETIME(3) NOT NULL COMMENT '事件在生产者侧发生的墙钟时间',
  received_at DATETIME(3) NOT NULL COMMENT '状态服务接收到事件的时间',
  committed_at DATETIME(3) NOT NULL COMMENT '事件在 MySQL 中提交的时间',
  duration_ms BIGINT UNSIGNED NULL COMMENT '生产者测量的事件或步骤耗时,单位毫秒',
  payload JSON NULL COMMENT '审计和回放所需的扩展事件数据',
  PRIMARY KEY (event_id),
  UNIQUE KEY task_event_version_uk (task_id, task_version),
  KEY task_event_timeline_idx (task_id, committed_at, event_id),
  UNIQUE KEY task_step_event_seq_uk
    (task_id, step_id, step_attempt, source_seq)
) ENGINE=InnoDB COMMENT='已接受状态事件的不可变时间线与版本审计记录';

CREATE TABLE task_event_dedup (
  event_id CHAR(36) NOT NULL COMMENT '生产者生成的全局幂等事件 ID',
  task_id CHAR(36) NOT NULL COMMENT '事件所属任务 ID',
  payload_hash CHAR(64) NOT NULL COMMENT '规范化事件内容的 SHA-256 摘要',
  result JSON NOT NULL COMMENT '首次处理结果,包含已分配版本等响应字段',
  created_at DATETIME(3) NOT NULL DEFAULT CURRENT_TIMESTAMP(3) COMMENT '首次处理并记录幂等结果的时间',
  PRIMARY KEY (event_id),
  KEY task_event_task_idx (task_id, created_at)
) ENGINE=InnoDB COMMENT='事件幂等判定与首次响应结果缓存';
task.coordinator_source_seq 只排序 Coordinator 产生的任务级事件;每个服务的步骤事件分别使用对应 task_step.source_seq。不能拿一个任务级 source_seq 比较所有服务,否则文件服务的 seq=2 会错误地把 AI 服务合法的 seq=1 当成旧消息。
5.1 MySQL Outbox 表
Centrifugo 当前的内置异步消费者列表没有 MySQL。因此这里不让 Centrifugo 直接扫描数据库,而是由独立的 Outbox Relay 从 MySQL 领取记录,再调用 Centrifugo HTTP 或 gRPC Server API。官方支持的内置消费者及自定义 consumer 接入边界见 Built-in API command async consumers。
CREATE TABLE task_outbox (
  id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT 'Outbox 自增主键',
  aggregate_id CHAR(36) NOT NULL COMMENT '聚合根 ID,此处为任务 ID',
  aggregate_version BIGINT UNSIGNED NOT NULL COMMENT '消息对应的任务级版本',
  channel VARCHAR(255) NOT NULL COMMENT '服务端计算出的 Centrifugo 目标频道',
  projection VARCHAR(32) NOT NULL COMMENT 'USER_SUMMARY、TASK_DETAIL 或广播投影类型',
  payload JSON NOT NULL COMMENT '包含完整任务状态的发布载荷',
  status VARCHAR(16) NOT NULL DEFAULT 'PENDING' COMMENT 'PENDING、PROCESSING、PUBLISHED 或 DEAD',
  available_at DATETIME(3) NOT NULL DEFAULT CURRENT_TIMESTAMP(3) COMMENT '允许 Relay 下一次领取的时间',
  locked_by VARCHAR(128) NULL COMMENT '当前领取该记录的 Relay 实例 ID',
  locked_at DATETIME(3) NULL COMMENT 'Relay 获得领取租约的时间',
  attempts INT UNSIGNED NOT NULL DEFAULT 0 COMMENT '累计发布尝试次数',
  last_error VARCHAR(1024) NULL COMMENT '最近一次脱敏后的发布错误',
  created_at DATETIME(3) NOT NULL DEFAULT CURRENT_TIMESTAMP(3) COMMENT 'Outbox 记录创建时间',
  published_at DATETIME(3) NULL COMMENT '最近一次成功发布时间',
  PRIMARY KEY (id),
  UNIQUE KEY outbox_aggregate_version_channel_uk
    (aggregate_id, aggregate_version, channel, projection),
  KEY outbox_claim_idx (status, available_at, id),
  KEY outbox_lock_timeout_idx (status, locked_at)
) ENGINE=InnoDB COMMENT='状态变化的事务发布命令与 Relay 租约状态';
状态更新和通知命令在同一个 InnoDB 事务中提交:
START TRANSACTION;

SELECT version
FROM task
WHERE id = :task_id
FOR UPDATE;

SELECT version, source_seq, operation_code
FROM task_step
WHERE task_id = :task_id
  AND step_id = :step_id
  AND attempt = :step_attempt
FOR UPDATE;

UPDATE task_step
SET lifecycle_status = :step_lifecycle_status,
    business_status = :business_status,
    health = :step_health,
    data_schema = :data_schema,
    state_data = CAST(:state_data_json AS JSON),
    error_category = :error_category,
    error_code = :error_code,
    error_message = :error_message,
    error_retryable = :error_retryable,
    diagnostics_ref = :diagnostics_ref,
    source_seq = :source_seq,
    version = :new_step_version,
    updated_at = UTC_TIMESTAMP(3)
WHERE task_id = :task_id
  AND step_id = :step_id
  AND attempt = :step_attempt
  AND source_seq < :source_seq;

UPDATE task
SET lifecycle_status = :lifecycle_status,
    business_status = :business_status,
    health = :task_health,
    summary_schema = :summary_schema,
    summary_data = CAST(:summary_data_json AS JSON),
    failure_code = :failure_code,
    failure_message = :failure_message,
    failed_step_id = :failed_step_id,
    version = :new_version,
    updated_at = UTC_TIMESTAMP(3)
WHERE id = :task_id
  AND attempt = :task_attempt;

INSERT INTO task_outbox (
  aggregate_id,
  aggregate_version,
  channel,
  projection,
  payload
) VALUES (
  :task_id,
  :new_version,
  :channel,
  :projection,
  CAST(:complete_state_json AS JSON)
);

INSERT INTO task_event_log (
  event_id,
  task_id,
  task_version,
  step_id,
  operation_code,
  step_version,
  task_attempt,
  step_attempt,
  producer_id,
  source_seq,
  event_type,
  lifecycle_status,
  business_status,
  health,
  data_schema,
  error_code,
  occurred_at,
  received_at,
  committed_at,
  duration_ms,
  payload
) VALUES (
  :event_id,
  :task_id,
  :new_version,
  :step_id,
  :operation_code,
  :new_step_version,
  :task_attempt,
  :step_attempt,
  :producer_id,
  :source_seq,
  :event_type,
  :lifecycle_status,
  :business_status,
  :health,
  :data_schema,
  :error_code,
  :occurred_at,
  :received_at,
  UTC_TIMESTAMP(3),
  :duration_ms,
  CAST(:event_payload_json AS JSON)
);

INSERT INTO task_event_dedup (
  event_id,
  task_id,
  payload_hash,
  result
) VALUES (
  :event_id,
  :task_id,
  :payload_hash,
  CAST(:result_json AS JSON)
);

COMMIT;
实际实现应先 SELECT ... FOR UPDATE 锁定任务并读取当前版本,再完成状态机校验和更新;不要依赖上面简化 SQL 猜测 :new_version。
同一已接受事件可以在事务内生成多条不同频道的 Outbox 记录:用户频道写 USER_SUMMARY 投影,任务频道写 TASK_DETAIL 投影。投影器从已校验的当前状态构建载荷,不能把 Worker 原始 JSON 原样转发;否则来源服务可能绕过字段裁剪,把只允许出现在详情中的数据泄漏到摘要或广播频道。
5.2 多副本 Relay 如何安全领取
多个 Relay 可以使用 MySQL 8.0 的 FOR UPDATE SKIP LOCKED 并发领取不同记录。MySQL 官方明确指出,SKIP LOCKED 会跳过已经被其他事务锁定的行,适合多个会话访问同一队列表;它不适合需要一致性视图的普通业务查询。参见 InnoDB Locking Reads。
START TRANSACTION;

SELECT id
FROM task_outbox
WHERE status = 'PENDING'
  AND available_at <= UTC_TIMESTAMP(3)
ORDER BY id
LIMIT 100
FOR UPDATE SKIP LOCKED;

UPDATE task_outbox
SET status = 'PROCESSING',
    locked_by = :relay_id,
    locked_at = UTC_TIMESTAMP(3),
    attempts = attempts + 1
WHERE id IN (:claimed_ids);

COMMIT;
Relay 在事务外调用 Centrifugo Server API,成功后将记录更新为 PUBLISHED。失败时按指数退避计算新的 available_at,回到 PENDING。如果 Relay 在“发布成功、标记完成之前”崩溃,记录会在锁租约过期后重试,因此客户端必须允许重复消息。
每条消息必须携带完整状态和 aggregate_version。这样即使多个 Relay 导致同一任务的通知晚到或乱序,客户端仍会忽略旧版本,正确性不依赖严格的全局发布顺序。
如果 Worker 已完成业务,却在状态上报前崩溃,状态服务的 Outbox 无法凭空知道这次完成。来源服务仍需要持久化重试、本地 Outbox,或由对账任务查询实际结果并修复状态。
六、通知设计:可选传输、有限订阅与受控广播
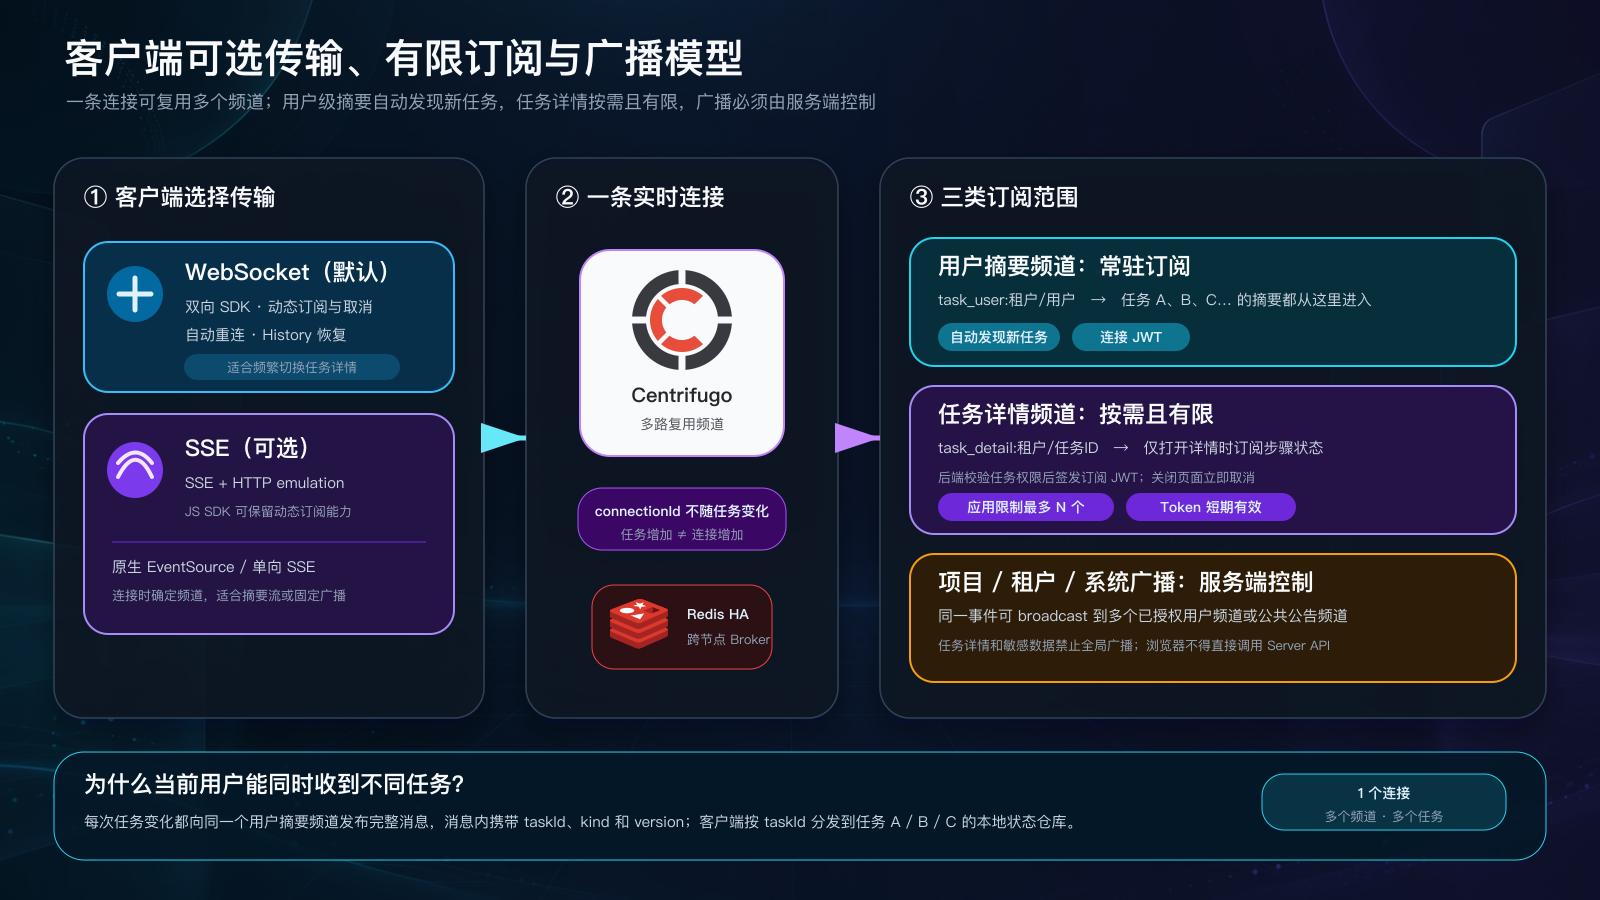
订阅模型图:一条物理连接可以复用多个逻辑频道;用户摘要常驻,任务详情按需且有限,项目、租户与系统广播只能由服务端授权和发布。
6.1 用户摘要频道
登录期间始终订阅:
task_user:{tenantId}/{userId}
它发送用户有权看到的任务摘要:
{
  "kind": "task.summary",
  "schemaVersion": 1,
  "task": {
    "id": "8a4d",
    "product": "DOCUMENT",
    "taskType": "DOCUMENT_PROCESS",
    "title": "合同解析",
    "lifecycleStatus": "RUNNING",
    "businessStatus": "WAITING_REVIEW",
    "health": "HEALTHY",
    "version": "12",
    "startedAt": "2026-09-21T07:10:00Z",
    "finishedAt": null,
    "elapsedMs": 18000,
    "asOf": "2026-09-21T07:10:18Z",
    "summaryData": {
      "schema": "document.process.summary.v1",
      "value": {"fileName": "contract.pdf", "pageCount": 36}
    }
  }
}
新任务 B、C、D 都归入同一用户频道,所以不需要重建连接,也不需要提前知道未来的任务 ID。
这也是“当前用户如何同时收到不同任务数据”的关键:不是给每个任务各建一条 WebSocket,而是所有任务摘要都发布到当前用户唯一的摘要频道。消息带上 taskId、kind 与 version,客户端再路由到不同本地对象:
function onPublication(message: TaskSummaryMessage) {
  const current = taskStore.get(message.task.id);
  if (!current || BigInt(message.task.version) > BigInt(current.version)) {
    taskStore.set(message.task.id, message.task);
  }
}
无论任务 A、B、C 谁先变化,都进入同一个连接;任务 D 刚刚创建,也会自动出现在频道中。Centrifugo 的服务器侧订阅正适合这种用户个人频道,且官方建议用个人频道承载用户更新,避免为大量对象逐个创建订阅。参见 Server-side subscriptions 与 FAQ: scalability considerations。
6.2 任务详情频道
用户打开详情时按需订阅:
task_detail:{tenantId}/{taskId}
关闭详情时只取消这个订阅,应用级连接仍保留。详情消息携带任务本身和步骤的完整当前状态:
{
  "kind": "task.detail",
  "schemaVersion": 1,
  "taskId": "8a4d",
  "version": "12",
  "taskType": "DOCUMENT_PROCESS",
  "lifecycleStatus": "RUNNING",
  "businessStatus": "PARSING",
  "steps": [
    {
      "id": "01_prepare",
      "operationCode": "FILE.PREPARE",
      "lifecycleStatus": "SUCCEEDED",
      "businessStatus": "PREPARED",
      "durationMs": 3000
    },
    {
      "id": "02_parse",
      "operationCode": "DOCUMENT.PARSE",
      "lifecycleStatus": "RUNNING",
      "businessStatus": "PARSING",
      "startedAt": "2026-09-21T07:10:03Z",
      "data": {
        "schema": "document.parse.progress.v1",
        "value": {"currentPage": 18, "totalPages": 36}
      }
    },
    {
      "id": "03_store",
      "operationCode": "RESULT.PERSIST",
      "lifecycleStatus": "PENDING",
      "businessStatus": "QUEUED"
    }
  ]
}
6.3 为什么分两级
| 只用用户频道 | 只用任务频道 | 两级订阅 |
|---|---|---|
| 容易发现新任务,但所有步骤详情会广播过多 | 详情精确,但新任务需要不断新增订阅 | 列表自动发现,详情按需加载 |
用户有一万个历史任务时,摘要频道仍应只推发生变化的当前摘要;列表快照使用分页。详情频道只服务正在查看该任务的客户端。
6.4 客户端可选 WebSocket 或 SSE
传输方式不改变频道模型、鉴权或版本规则,只改变连接如何承载消息:
| 模式 | 能力 | 适用场景 | 限制 |
|---|---|---|---|
| WebSocket | 双向、动态订阅/取消、自动重连与 History 恢复 | Web、桌面和原生 App 的默认选择 | 某些企业代理可能限制升级连接 |
| SSE + HTTP emulation | 下行使用 SSE,上行命令使用 HTTP;JS SDK 仍可动态订阅 | WebSocket 不可用时的浏览器回退 | 请求数和代理配置比 WebSocket 更复杂 |
| 原生单向 SSE / EventSource | 简单的服务器到客户端事件流 | 固定用户摘要、只读大屏、轻量广播 | 连接建立后不适合频繁动态增减详情订阅 |
在浏览器中,可以让 SDK 按顺序尝试 WebSocket 与双向 SSE emulation:
import { Centrifuge } from 'centrifuge';

const realtime = new Centrifuge(
  [
    {
      transport: 'websocket',
      endpoint: 'wss://realtime.example.com/connection/websocket',
    },
    {
      transport: 'sse',
      endpoint: 'https://realtime.example.com/connection/sse',
    },
  ],
  {
    token: connectionToken,
    getToken: refreshConnectionToken,
  },
);
双向 SSE emulation 不是“只有下行的 EventSource”:SDK 通过 SSE 接收,通过 HTTP emulation 发送订阅等命令,因此仍能保留动态频道能力。原生单向 SSE 则适合连接时已经确定好的服务器侧订阅;如果页面需要频繁切换任务详情,优先使用 WebSocket 或双向 SSE emulation。参见 Transport overview、SSE bidirectional emulation 与 Unidirectional SSE。
6.5 任务详情订阅必须有限
“按需订阅”不等于“可以无限订阅”。推荐把限制分成三层:
- UI 只订阅当前打开、可见或固定关注的任务,页面离开后立即取消;
- 业务后端签发订阅 JWT 前检查任务 ACL、会话和应用级配额;
- 高风险场景启用订阅代理或由后端调用 Server API 动态订阅,把最终授权留在服务端。
例如产品可以配置 maxDetailSubscriptionsPerConnection = 20,这是应用策略,不是协议常量。超过上限时,客户端应先按 LRU 取消最早不可见的详情频道,再申请新频道;后端返回明确的 DETAIL_SUBSCRIPTION_LIMIT,不能静默放宽权限。
常驻:task_user:t1/u1                         1 个
按需:task_detail:t1/task-a ... task-t       最多 20 个
总览:其余任务仍通过用户摘要频道持续收到变化
仅在客户端计数属于体验优化,不是安全边界。强制限制需要服务端维护连接或会话的订阅租约,并在签发 token、订阅代理或动态订阅时原子检查;短期订阅 JWT 还应绑定 sub + channel + exp。Centrifugo 的频道权限模式可参考 Channel permissions。
6.6 广播支持:广播范围越大,载荷越小
系统可以支持广播,但必须先定义范围:
| 范围 | 频道示例 | 可以发送 | 不应该发送 |
|---|---|---|---|
| 当前用户 | task_user:t1/u1 | 该用户任务摘要 | 其他用户数据 |
| 项目成员 | task_project:t1/p9 | 项目级任务概览 | 无权限成员的结果、密钥、完整错误栈 |
| 租户 | task_tenant:t1 | 维护提示、租户级批处理进度 | 单个用户的敏感任务详情 |
| 系统公共 | task_system:public | 版本通知、公开维护状态 | 任何业务任务数据 |
同一个事件需要到达多个已授权频道时,Outbox Relay 可以调用 Centrifugo broadcast Server API;第一版也可以展开成多条 publish Outbox 记录,换取更简单的逐频道重试与审计。大规模广播应分批异步执行,避免一次命令过大阻塞普通任务通知。官方 Server API 支持对一组频道广播相同数据,见 Server API broadcast。
{
  "method": "broadcast",
  "channels": [
    "task_user:t1/u1",
    "task_project:t1/p9"
  ],
  "data": {
    "kind": "task.summary",
    "taskId": "8a4d",
    "version": "12",
    "lifecycleStatus": "RUNNING",
    "businessStatus": "WAITING_REVIEW"
  }
}
浏览器不能直接调用 Server API,也不能自己决定广播目标。业务服务先计算接收范围,事务内写入可审计的 Outbox 命令,Relay 才能执行发布。
6.7 一条连接为何能承载多个任务
Centrifugo 在一条传输连接上复用多个逻辑频道。连接身份保持不变,任务集合通过两条路径变化:
新任务出现
  → 用户摘要频道自动收到 task.summary
  → 不需要新增连接或订阅

用户打开某个任务
  → 申请该 task_detail 的短期订阅授权
  → 在现有连接上增加逻辑订阅
  → 关闭页面时取消,不影响其他任务
因此连接数大致随在线用户数增长,而不是随“在线用户数 × 历史任务数”增长;活跃详情订阅数则由页面行为和应用配额独立控制。
6.8 异常时如何让用户真正收到任务状态
异常状态不能只写进步骤表,更不能只发到“用户可能没有订阅”的详情频道。每次已确认异常至少生成两个投影:
task_user:{tenantId}/{userId}收到带异常摘要的完整task.summary,保证用户只订阅一个常驻频道也能发现失败;task_detail:{tenantId}/{taskId}收到步骤、功能数据和脱敏错误详情,供已经打开详情的页面展示。
用户摘要消息仍然是完整任务当前值,只额外包含一个可选 notice。这样客户端收到通知时可以同时更新列表、显示 Toast,并按 taskId + version 去重:
{
  "kind": "task.summary",
  "schemaVersion": 1,
  "task": {
    "id": "task-8a4d",
    "taskType": "DOCUMENT_PROCESS",
    "lifecycleStatus": "FAILED",
    "businessStatus": "PARSE_FAILED",
    "health": "HEALTHY",
    "version": "13",
    "failedStepId": "02_parse"
  },
  "notice": {
    "id": "task-8a4d:13",
    "type": "TASK_FAILED",
    "level": "ERROR",
    "title": "合同解析失败",
    "message": "暂不支持该文件格式,请转换为 PDF 后重试",
    "operationCode": "DOCUMENT.PARSE",
    "errorCode": "UNSUPPORTED_FILE_FORMAT",
    "retryable": false,
    "requiresAction": true,
    "actions": ["REUPLOAD_FILE", "VIEW_DETAILS"]
  }
}
通知策略要由最终状态和异常类型驱动:
| 已确认事实 | 用户摘要频道 | 任务详情频道 | 可选离线通知 |
|---|---|---|---|
STEP_FAILED,准备自动重试 | WARNING:“步骤失败,正在重试” | 完整失败 attempt 和下一轮信息 | 通常不发 |
| 可选步骤失败、任务继续 | WARNING,任务标记 DEGRADED | 错误详情与受影响功能 | 仅业务要求时发送 |
TASK_FAILED | ERROR,必须发布且不能被进度合并吞掉 | 最终错误、失败步骤和可执行操作 | 可按用户偏好发送站内信、Push 或邮件 |
health=STALE | WARNING:“状态暂时无法确认” | 最近心跳和检测时间 | 通常不发,持续超阈值再升级 |
| 实时连接中断 | 本地显示 RECOVERING/STALE | 重连后 History 或快照恢复 | 不能把连接故障通知成任务失败 |
中间 STEP_PROGRESS 可以按短窗口合并,但 STEP_FAILED、TASK_FAILED、CANCELLED、SUCCEEDED 和 requiresAction=true 的消息必须绕过普通进度合并。若 Relay 多次重试后进入 DEAD,这是运维告警,不是业务失败;客户端最终仍通过 MySQL 快照获得真实终态。
WebSocket/SSE 只覆盖在线连接。产品如果要求“用户离线也必须知道任务失败”,应把终态或需人工处理的事件同时写入独立、持久化的通知命令,由 Notification Service 生成站内未读记录并按用户偏好发送 Push/邮件。其幂等键可使用 userId + taskId + taskVersion + notificationType,避免 Relay 重试导致重复提醒。
七、认证与授权:频道名不是权限
7.1 连接 JWT
前端先用已有登录会话请求实时连接信息:
GET /api/realtime/session
后端从已验证身份中读取租户和用户,签发短期连接 JWT:
{
  "sub": "t1/u1",
  "channels": ["task_user:t1/u1"],
  "aud": "task-realtime",
  "iss": "task-status-service",
  "exp": 1789981200
}
channels 会在连接建立时创建服务器侧订阅。官方特别说明,这个 claim 表示“自动订阅”,不是一张任意频道权限清单。参见 Client JWT authentication。
7.2 订阅 JWT
打开任务详情时,前端向业务后端请求:
POST /api/realtime/subscription-token
Content-Type: application/json

{"taskId":"8a4d"}
后端必须重新执行任务权限检查:
验证登录身份
  → 查询任务 tenantId / ownerId / project ACL
  → 构造服务端认可的准确频道
  → 签发 channel + sub + exp
{
  "sub": "t1/u1",
  "channel": "task_detail:t1/8a4d",
  "exp": 1789981200
}
订阅 JWT 的 sub 必须与连接用户一致,channel 必须是后端完成授权后构造的值。参见 Channel JWT authorization。
下面这些做法都不安全:
- 相信浏览器提交的
tenantId、userId或完整频道名; - 把其他用户数据推到前端,再依赖 UI 隐藏;
- 把 JWT 签名密钥或 Centrifugo Server API Key 发给浏览器;
- 为解决 403,直接允许所有登录用户订阅任意任务频道。
八、客户端合并:快照和推送一定会乱序
8.1 每个对象只接受更高版本
type Versioned = {
  id: string;
  version: bigint;
};

function shouldApply(local: Versioned | undefined, incoming: Versioned) {
  return !local || incoming.version > local.version;
}
版本建议以十进制字符串通过 JSON 传输,再在支持的客户端转换成 64 位整数或 bigint,避免 JavaScript number 的安全整数上限问题。
8.2 摘要与详情分别维护版本门
summaryVersion[taskId] = 12
detailVersion[taskId]  = 10
收到 task.summary version=12,不能认为 task.detail version=12 已经处理,因为摘要并不包含步骤集合。摘要和详情要分别缓存、分别合并。
8.3 初始化采用“先订阅、后快照”
如果先查快照、再建立订阅,状态可能恰好在两者之间改变并被漏掉。订阅后缓冲、再加载快照、最后按版本重放,才能关闭这个竞态窗口。
8.4 重连采用两级恢复
Centrifugo 的双向 SDK 会保存频道 epoch/offset,在重订阅时尝试补齐短暂断线期间的消息;只有当历史连续可用时才返回恢复成功,否则应用应加载业务快照。官方恢复流程见 Stream history and recovery。
对任务状态这种“当前值”系统,发布完整对象而不是差量补丁更容易恢复。即使漏掉:
PENDING → RUNNING → SUCCEEDED
只要最终收到更高版本的完整 SUCCEEDED 状态,客户端就能收敛;如果业务需要每个中间事件都可审计,应额外建设不可变事件表,而不是依赖实时频道历史。
8.5 状态合并和用户提醒要使用不同的去重门
任务状态按 taskId + version 合并;Toast、声音或系统通知则按 notice.id 去重。二者不能共用一个布尔值:页面可能已经通过快照得到 version=13,随后又收到同版本实时消息,此时不应回退状态,也不应重复弹出已读提醒。
function handleSummary(message: TaskSummaryMessage) {
  mergeTaskWhenVersionIsNewer(message.task);

  if (message.notice && !noticeStore.hasSeen(message.notice.id)) {
    showNotice(message.notice);
    noticeStore.markSeen(message.notice.id);
  }
}
若“未读”需要跨设备同步,就把已读状态保存到持久化通知中心;浏览器本地集合只能防止单页面重复弹窗。重新加载历史快照时默认更新任务卡片,不重新弹出旧终态;只有持久化通知中心仍标记为未读时才展示未读入口。
九、耗时:后端确认,前端平滑显示
9.1 运行中不需要每秒推送
后端在步骤开始时发送:
{
  "lifecycleStatus": "RUNNING",
  "businessStatus": "PARSING",
  "elapsedMs": 37000,
  "asOf": "2026-09-21T07:10:37Z"
}
前端记录收到消息时的单调时钟:
const receivedAt = performance.now();
const baseElapsedMs = task.elapsedMs;

function displayedElapsedMs() {
  return baseElapsedMs + performance.now() - receivedAt;
}
页面使用一个共享定时器刷新可见行即可。这不会产生网络请求、推送或数据库写入。
9.2 终态使用后端最终值
{
  "lifecycleStatus": "SUCCEEDED",
  "businessStatus": "COMPLETED",
  "durationMs": 42000
}
收到终态后停止本地累加。浏览器从休眠或后台恢复、页面重新获得可见性、系统网络切换后,应重新获取当前状态校准。
9.3 明确耗时口径
| 指标 | 推荐定义 |
|---|---|
| 排队耗时 | startedAt - createdAt |
| 当前尝试耗时 | 当前 attempt 的开始到结束 |
| 任务总耗时 | 任务正式开始到权威终态的墙钟时间 |
| Worker 执行耗时 | Worker 使用单调时钟测量并在终态上报 |
| 并行步骤耗时 | 分别展示,不能直接相加为用户等待时间 |
跨机器时间戳适合表达时间线,但不适合在时钟未可靠同步时精确计算 Worker 内部耗时。精确执行时长应由同一进程的单调时钟测量。
十、通知可靠性:不要说“消息绝不丢”
这条链路包含不同层次的保证:
| 链路 | 目标语义 | 处理方式 |
|---|---|---|
| Worker → 状态服务 | 幂等重试 | eventId + payloadHash |
| 状态服务 → MySQL | 原子提交 | 当前状态、不可变事件、版本、去重结果、Outbox 同一个 InnoDB 事务 |
| MySQL Outbox → Relay | 多副本竞争领取 | SKIP LOCKED、锁租约、失败退避 |
| Relay → Centrifugo | 至少一次 | 发布失败重试,崩溃窗口允许重复 |
| Centrifugo → 在线客户端 | 实时分发 + 有界恢复 | history、positioning、SDK recovery |
| 客户端 → 最终视图 | 最终收敛 | 完整对象、version 去重、快照兜底 |
Relay 必须自己区分可重试错误和永久错误:网络超时、429、5xx 进入带抖动的指数退避;无效频道或无法序列化的消息进入 DEAD 并告警,不能无限热循环。不能因为使用了 Outbox 就宣称整条链路“绝不丢”;官方也建议应用处理异步发布中的重复与晚到消息,详见 async consumers。
真正可对外承诺的语义应该是:
状态服务成功响应,表示状态已持久化;实时通知可能重复、乱序或短暂中断,但客户端会通过版本和权威快照重新收敛。
十一、高可用:逐层消除单点
11.1 生产拓扑
11.2 Task Status Service
状态服务保持无状态并运行至少两个副本:
- 登录身份和服务身份从可验证 Token 或 mTLS 获取;
- 不把幂等结果、任务锁、订阅权限只保存在单机内存;
- 每个请求有 deadline,数据库连接池有上限;
- 就绪检查必须验证进程是否能够服务,但不要把瞬时下游抖动放大成全部 Pod 同时摘除;
- 发布版本时先停止接收新流量,再等待在途事务完成。
并发更新同一个任务时,用任务行锁、乐观版本或按 taskId 分区的有序处理保证单任务串行;不要使用覆盖整个平台的全局锁。
11.3 MySQL
MySQL 保存唯一权威状态,因此它的 RPO/RTO 比实时网关更重要:
- 使用 InnoDB、托管 Multi-AZ,或经过演练的 Group Replication / InnoDB Cluster;
- 自动备份与时间点恢复不能省略;
- 应用通过稳定 writer endpoint 连接,而不是写死节点 IP;
- 故障切换期间,写入可以短暂失败,调用方按同一个
eventId重试; - 定期做恢复演练,证明备份真的能还原,而不是只证明“备份任务显示成功”。
Outbox 与业务表在同一个数据库事务中,数据库切换后它们一起保留或一起回滚,不会出现跨两个存储提交一半的状态。
如果自建高可用,MySQL 官方说明 Group Replication 可以运行在 single-primary 模式并自动选举新主,但客户端仍需要 MySQL Router、代理或连接器切换到新节点;它本身不替应用完成连接故障转移。参见 Group Replication。时间点恢复则依赖完整备份后的 binary log,参见 Point-in-Time Recovery。
11.4 Outbox Relay
Relay 至少运行两个副本,并把正确性放在 MySQL 中,而不是本机内存:
- 使用
FOR UPDATE SKIP LOCKED领取互不重叠的批次; locked_at是租约而不是永久所有权,超时记录可被其他副本接管;- 发布 API 使用短 deadline,失败后释放记录并延迟重试;
- 单条永久错误进入死信状态,不阻塞后续记录;
- 滚动发布时停止领取新批次,处理完已领取记录再退出;
- 定期清理已发布记录,但保留足够窗口用于排障和审计。
Relay 不需要强制全局有序,因为消息包含完整状态与单调版本。若某个下游真的要求严格的单任务事件顺序,则需要再按 aggregate_id 做稳定分区并为每个分区维护单一租约。
11.5 Centrifugo
单节点验证可以使用 memory engine,但生产多副本需要共享 Engine。Centrifugo 官方说明,Redis engine 会在节点之间传播发布,并保存频道 history/presence;客户端连接任意节点都能接收目标频道消息。参见 Engines and scalability。
示意配置如下:
{
  "engine": {
    "type": "redis",
    "redis": {
      "address": "redis+sentinel://redis-sentinel-a:26379?sentinel_master_name=realtime&addr=redis-sentinel-b:26379"
    }
  }
}
Relay 通过任意健康 Centrifugo 节点的 Server API 发布。共享 Redis Engine 会把消息转发到真正持有目标订阅的节点,因此 Relay 不需要知道某个浏览器连接在哪个 Pod。
11.6 Redis
两个 Centrifugo Pod 配一个单机 Redis,仍然只有一个新的单点。可选方式包括:
- 托管高可用 Redis;
- Redis Sentinel 主从切换;
- Redis Cluster;
- 规模更大时按频道进行应用级分片。
Sentinel 切换存在检测与选主窗口,因此高可用不等于零中断。连接侧必须允许重连,业务侧必须允许回快照。
11.7 负载均衡与连接排空
负载均衡器需要支持 WebSocket 升级和足够长的空闲超时。滚动发布时:
Pod 进入 terminating
  → readiness 变为 false
  → 不再接收新连接
  → 给存量连接一个排空窗口
  → 客户端重连到其他健康节点
  → SDK recovery 或业务快照补齐
不要求客户端永远粘在同一个节点;共享 Redis Engine 让新节点仍能访问同一频道分发与短期历史。粘性会话可以减少迁移,但不能成为正确性的前提。
十二、故障矩阵:每一层坏掉时会发生什么
| 故障 | 用户看到什么 | 系统如何恢复 | 不应发生什么 |
|---|---|---|---|
| 一个 Status API Pod 崩溃 | 某次请求失败或重试 | LB 切到其他 Pod,同 eventId 重试 | 重试生成两次状态变化 |
| MySQL 主库短暂切换 | 上报延迟、查询短暂失败 | writer endpoint 恢复后重试,事务原子性保持 | 返回成功但状态未落库 |
| Outbox Relay 暂停 | 数据库状态正确,页面更新延迟 | Relay 恢复后领取并清理积压 | 为追求实时绕过事实库 |
| 一个 Centrifugo Pod 崩溃 | 连接断开并重连 | 连接其他 Pod,先 recovery,失败则快照 | 把任务标成失败 |
| Redis 主节点切换 | 部分发布/恢复短暂失败 | Centrifugo 重连 Redis,客户端快照兜底 | 依赖 history 作为唯一事实 |
| 浏览器休眠 | 耗时暂时不刷新 | 恢复可见时重新校准 | 用错误本地时钟写回后端 |
| 消息重复 | 无可见变化 | version 忽略同版或旧版 | 重复新增任务行 |
| 消息乱序 | 无可见回退 | 仅应用更高版本 | 终态退回 RUNNING |
| 步骤业务失败 | 列表收到警告或失败摘要,详情显示具体功能与错误 | Coordinator 按 failurePolicy 重试、继续或提交 TASK_FAILED | 只在详情频道发送,导致列表用户完全不知情 |
| Worker 心跳超时 | 显示“状态待确认” | Health Reconciler 提交 health=STALE,恢复心跳后再提交 HEALTHY | 未确认事实时直接把任务写成 FAILED |
| Worker 完成后上报前崩溃 | 长时间 RUNNING / STALE | 来源 Outbox、持久重试或对账修复 | 认为中心 Outbox 能覆盖此缺口 |
高可用的目标不是让所有故障不可见,而是让故障有界、可观察、可恢复,并且不会破坏已确认事实。
十三、降级策略:实时层不可用时仍然可用
13.1 客户端连接状态
UI 应区分:
LIVE        实时连接正常
RECOVERING  正在重连和恢复
STALE       暂时无法确认最新状态
不要在连接断开时清空任务列表。保留最后一次已确认状态,显示“正在恢复实时更新”,并在恢复失败时触发批量快照。
13.2 低频批量校验
如果部署阶段尚未启用可靠 history,或希望防止某些静默丢失,可对当前可见且未终止的任务做低频批量校验,例如页面活跃时每 30~60 秒一次:
POST /api/tasks/status:batchGet

{"taskIds":["8a4d","9b5e"],"knownVersions":{"8a4d":"12","9b5e":"3"}}
轮询是兜底,不是每秒驱动 UI 的主链路。间隔应通过业务容忍度和容量测试确定,并加入随机抖动,避免所有客户端整点同时请求。
13.3 过载时优先保终态
中间 RUNNING 状态可以短窗口合并,但以下消息不能被普通合并规则吞掉:
SUCCEEDED、FAILED、CANCELLED;- 新任务创建;
- 新 attempt 开始;
- 权限撤销或任务删除;
- 需要用户操作的错误。
慢客户端积压时,可以丢弃可覆盖的旧摘要,只保留同一任务最高版本的完整状态;超过上限后主动断开,让客户端走恢复流程,不能无限增加内存队列。
十四、可观测性:监控正确性,而不只监控在线数
14.1 服务端指标
| 层 | 必须监控的指标 |
|---|---|
| 状态 API | 上报 QPS、P50/P95/P99、幂等命中、冲突、旧 attempt、功能身份不匹配、Schema 拒绝、非法转换 |
| MySQL | 事务延迟、InnoDB 行锁等待、连接池等待、复制延迟、切换事件 |
| Outbox Relay | 最老未发布年龄、PENDING/PROCESSING/DEAD 数量、领取与发布速率、租约超时、失败分类 |
| Centrifugo | 在线连接、订阅数、发布速率、节点间 Broker 错误、断开原因 |
| Redis | CPU、内存、连接、Pub/Sub、复制延迟、故障切换 |
| 客户端 | 连接成功率、重连次数、recovered=false 比例、快照耗时、未知功能/Schema、异常通知展示延迟 |
比“当前在线 10 万连接”更有价值的两个端到端指标是:
state_commit_to_publish_seconds
状态提交到实时发布的延迟

state_commit_to_visible_seconds
状态提交到客户端可见的延迟
14.2 日志关联
一次状态变化至少应能用下面的字段串起来:
traceId
eventId
taskId
stepId
taskType
operationCode
dataSchema
attempt
sourceSeq
taskVersion
errorCode
outboxId
channel
日志中不要记录完整 JWT、签名密钥、Server API Key 或敏感任务结果。
14.3 告警优先级
建议先对“用户会长期看到错误状态”的问题告警:
- Outbox 最老记录年龄持续增长;
- 状态提交成功但发布延迟超出 SLO;
recovered=false比例突增;- 未终止任务超过最大合理运行时长;
- 同一任务行锁等待和版本冲突异常升高;
TASK_FAILED已提交但用户摘要投影未发布;- 某个
operationCode的 Schema 拒绝或错误码突然激增; - Redis 或 MySQL 故障切换失败。
连接数下降可能只是业务低谷,Outbox 延迟上升却很可能意味着用户正在看到旧状态。
十五、容量模型:连接、变化和写入分开计算
假设:
在线连接                 100,000
活跃任务                  20,000
每个任务平均 30 秒一次状态变化
每次变化平均投递给 2 个客户端
平均消息体                    800 B
粗略估算:
状态写入:20,000 / 30 ≈ 667 次/秒
客户端投递:667 × 2 ≈ 1,334 次/秒
纯消息体流量:1,334 × 800 B ≈ 1.07 MB/秒
这还没有计入 TLS、协议头、心跳、重连和快照流量。连接数、状态变化量、数据库写入量和热门频道扇出是四个不同维度,不能用“支持百万 WebSocket”替代系统容量测试。
至少要压测以下场景:
- 大量空闲连接;
- 稳态状态上报;
- 单个热门项目的大扇出;
- Outbox 积压后追赶;
- 一个 Centrifugo 节点滚动下线;
- Redis 主从切换;
- MySQL 主备切换;
- 10%~30% 客户端同时重连;
- history 不足后集中读取快照。
十六、分阶段落地,不要第一天就堆满组件
阶段 1:单机验证
现有业务后端
  + MySQL 8.0
  + 单实例 Outbox Relay
  + 单实例 Centrifugo memory engine
先验证:
- 状态机与幂等;
taskType + operationCode + eventType的功能路由与权限校验;- 各功能
data.schema校验、差异化投影和未知 Schema 降级; - 多服务各自维护
sourceSeq,状态服务统一分配taskVersion; - 并发事件的任务版本唯一、递增,重复事件返回第一次分配的版本;
- Outbox 原子性;
- 用户摘要和任务详情频道;
- 失败、自动重试、
STALE与终态异常通知; - 订阅权限;
- 快照与实时消息合并;
- 前端本地计时。
阶段 2:生产高可用
Status API 多副本
  + MySQL Multi-AZ
  + Outbox Relay 多副本
  + Centrifugo 多副本
  + Redis HA Engine
  + LB / Ingress
加入滚动发布、连接排空、短期 history、恢复失败回快照、端到端告警和故障演练。
阶段 3:规模化
当证据表明 MySQL Outbox 扫描、Relay 发布或 Redis 成为瓶颈,再考虑:
- 增加 Outbox 分区;
- 将消费链路升级到 Kafka、NATS JetStream、Redis Streams 或云消息服务;
- 按租户或
taskId分片; - 管理看板只订阅聚合指标,不接收所有任务明细;
- 将审计历史与当前状态查询分离。
升级依据应该是积压、CPU、锁等待、恢复风暴和成本数据,而不是“系统看起来应该用 Kafka”。
十七、生产验收清单
正确性
- 相同
eventId重试不会产生第二次状态变化; - 相同
eventId携带不同内容会被拒绝; - Token、步骤定义与请求中的
taskType/operationCode/producerId不一致时会被拒绝; - 功能数据只接受注册过的
data.schema,未知 Schema 不会污染当前状态; - 同一功能的摘要、详情和广播投影遵守各自字段白名单;
- 旧 attempt、旧
sourceSeq、旧version都不能覆盖新状态; - 同一任务中,服务 A 的
sourceSeq=2不会让服务 B 的sourceSeq=1被误判为旧事件; - 两个服务并发上报时得到不同且连续递增的
taskVersion; - 重复
eventId返回第一次提交的taskVersion,不会再次增加版本; - 终态不会退回运行态;
- 未注册业务状态会被拒绝,业务状态只能映射到服务端定义的生命周期;
- 状态定义升级不会改变运行中和历史任务的语义;
- 当前状态、不可变事件、版本、幂等结果与 Outbox 在同一个事务里提交;
- 事件时间线可以从
afterTaskVersion断点续取,并能识别已被清理的历史窗口; - Worker 上报的单调时钟耗时不会被跨机器墙钟差值覆盖;
- 摘要和详情分别维护版本门;
- 初始化期间的新消息不会被旧快照覆盖。
- 客户端不认识某个
operationCode或data.schema时仍能展示通用生命周期状态。 - 用户未订阅任务详情时,仍能从用户摘要频道收到任务失败或需操作提醒。
-
STALE只改变健康状态,不会被误报成业务FAILED。 -
STEP_FAILED、终态和需操作通知不会被进度消息合并策略吞掉。
安全
- 连接 JWT 来自已验证登录身份;
- 任务详情 Token 在服务端重新检查权限;
- 浏览器无法自行指定其他租户频道;
- JWT 密钥、Server API Key 不出现在前端;
- 内部上报有服务身份认证、限流和审计。
- 任务详情订阅数在服务端强制限额,Token 短期有效;
- 项目、租户和系统广播不包含越权任务详情。
高可用
- Status API 任一副本退出后请求可重试;
- Centrifugo 任一节点退出后客户端能重连其他节点;
- Redis 与 MySQL 切换经过真实演练;
- Outbox 暂停后可以追赶且不会回退客户端状态;
- history 不足时客户端会读取快照;
- 重连风暴有退避、抖动和容量余量;
- 备份做过恢复验证。
可观测性
- 能查出某个
eventId对应的任务版本和 Outbox 记录; - 能看到 Outbox 最老积压年龄;
- 能区分发布失败、权限失败、恢复失败和快照失败;
- 有状态提交到客户端可见的端到端延迟指标;
- 对长期 RUNNING / STALE 任务有对账和修复流程。
十八、最终结论
任务状态同步系统最重要的设计原则不是选 SSE 还是 WebSocket,而是建立清晰的可靠性边界:
状态服务成功响应
  = 状态已经持久化

Outbox 发布
  = 尽力把已提交状态快速送到实时层

实时推送
  = 更快的用户体验,不是唯一事实

version + snapshot
  = 重复、乱序、断线和节点切换后的最终正确性
在这个边界之上,Centrifugo 解决连接、频道、重连与多节点分发,MySQL 负责权威状态和事务,Outbox Relay 负责可靠发布,Redis 负责实时集群协调,前端负责按版本合并和本地计时。任何一层短暂不可用,都不会要求重新定义业务状态。
最终可以把方案收敛为十三句话:
- 状态先落库,再通知;
- 同一事务写当前状态、不可变事件、版本、幂等结果和 Outbox;
- 每个服务只维护自己的
sourceSeq,状态服务统一分配任务级taskVersion; taskType区分整类任务,operationCode区分具体功能,eventType区分发生的动作;- 公共信封保持稳定,功能差异通过版本化
data.schema + data.value表达; - 稳定生命周期保证正确性,版本化业务状态负责产品表达;
- 失败、失联和通知故障分别建模,不能统一伪装成
FAILED; - 用户摘要发现多个新任务和异常,任务详情按需且有限订阅;
- 一条连接复用多个频道,客户端按环境选择 WebSocket 或 SSE;
- 连接 JWT 识别用户,订阅 JWT 授权具体任务;
- 广播范围由服务端计算,范围越大,载荷越小;
- 消息可以重复和乱序,客户端只接受更高版本;
- 短断线用 history 恢复,恢复失败读取权威快照;高可用的目标是断线后仍能安全收敛。
做到这些,系统才真正同时具备轻量、近实时、可扩展和可恢复,而不是只在演示环境里“看起来很实时”。