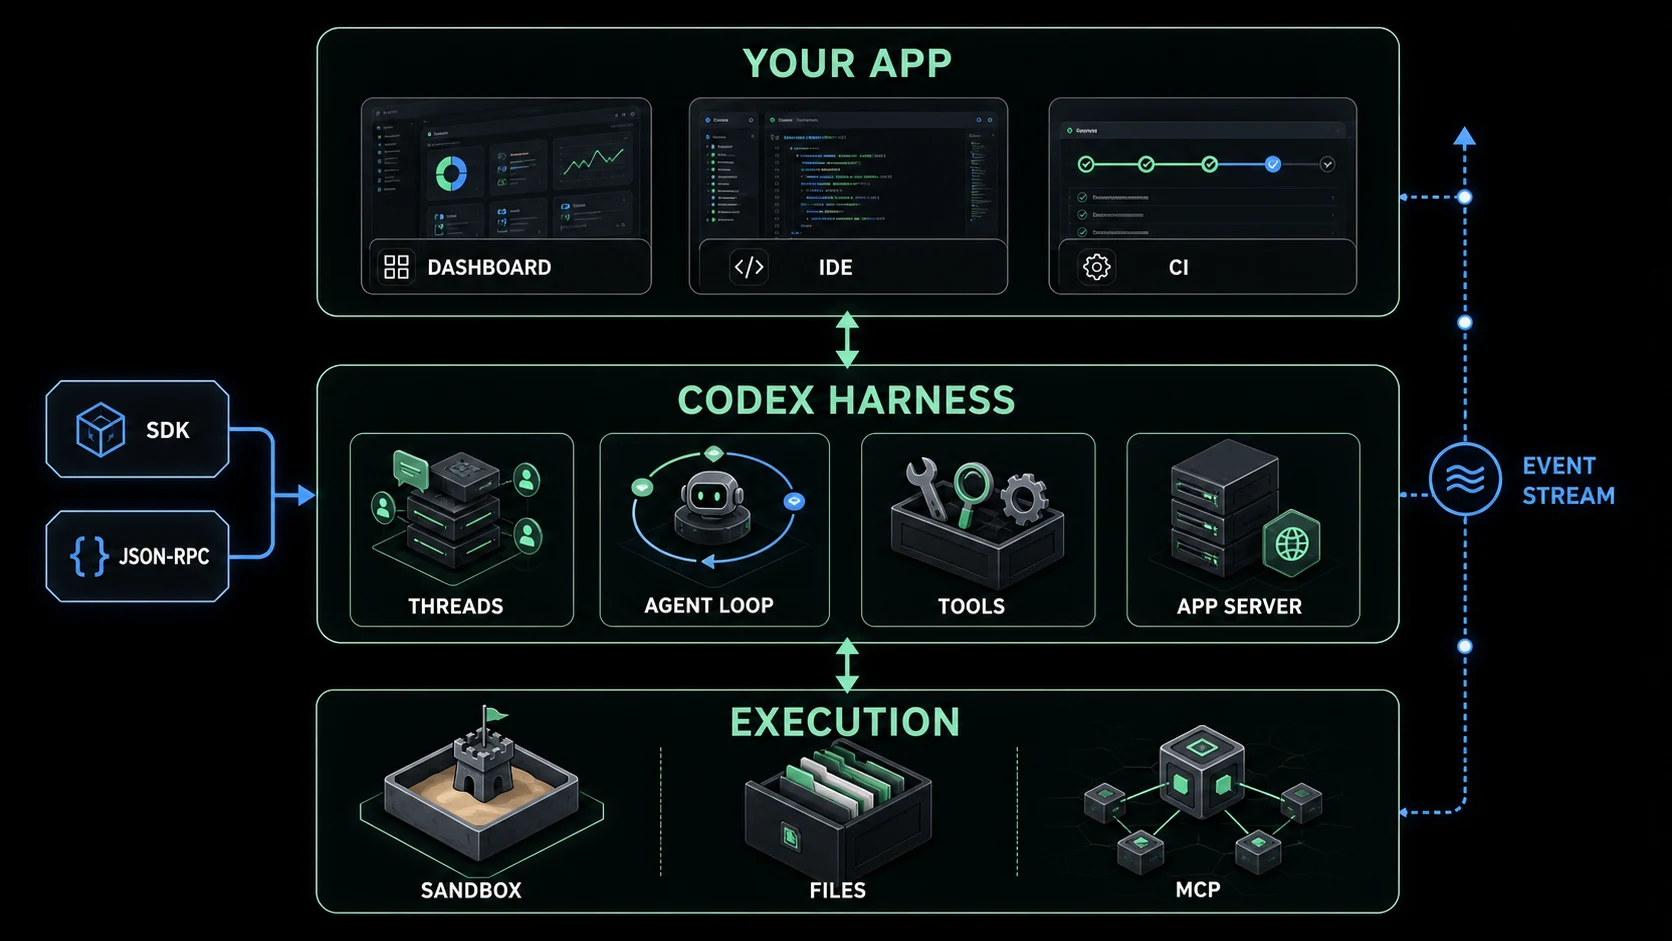
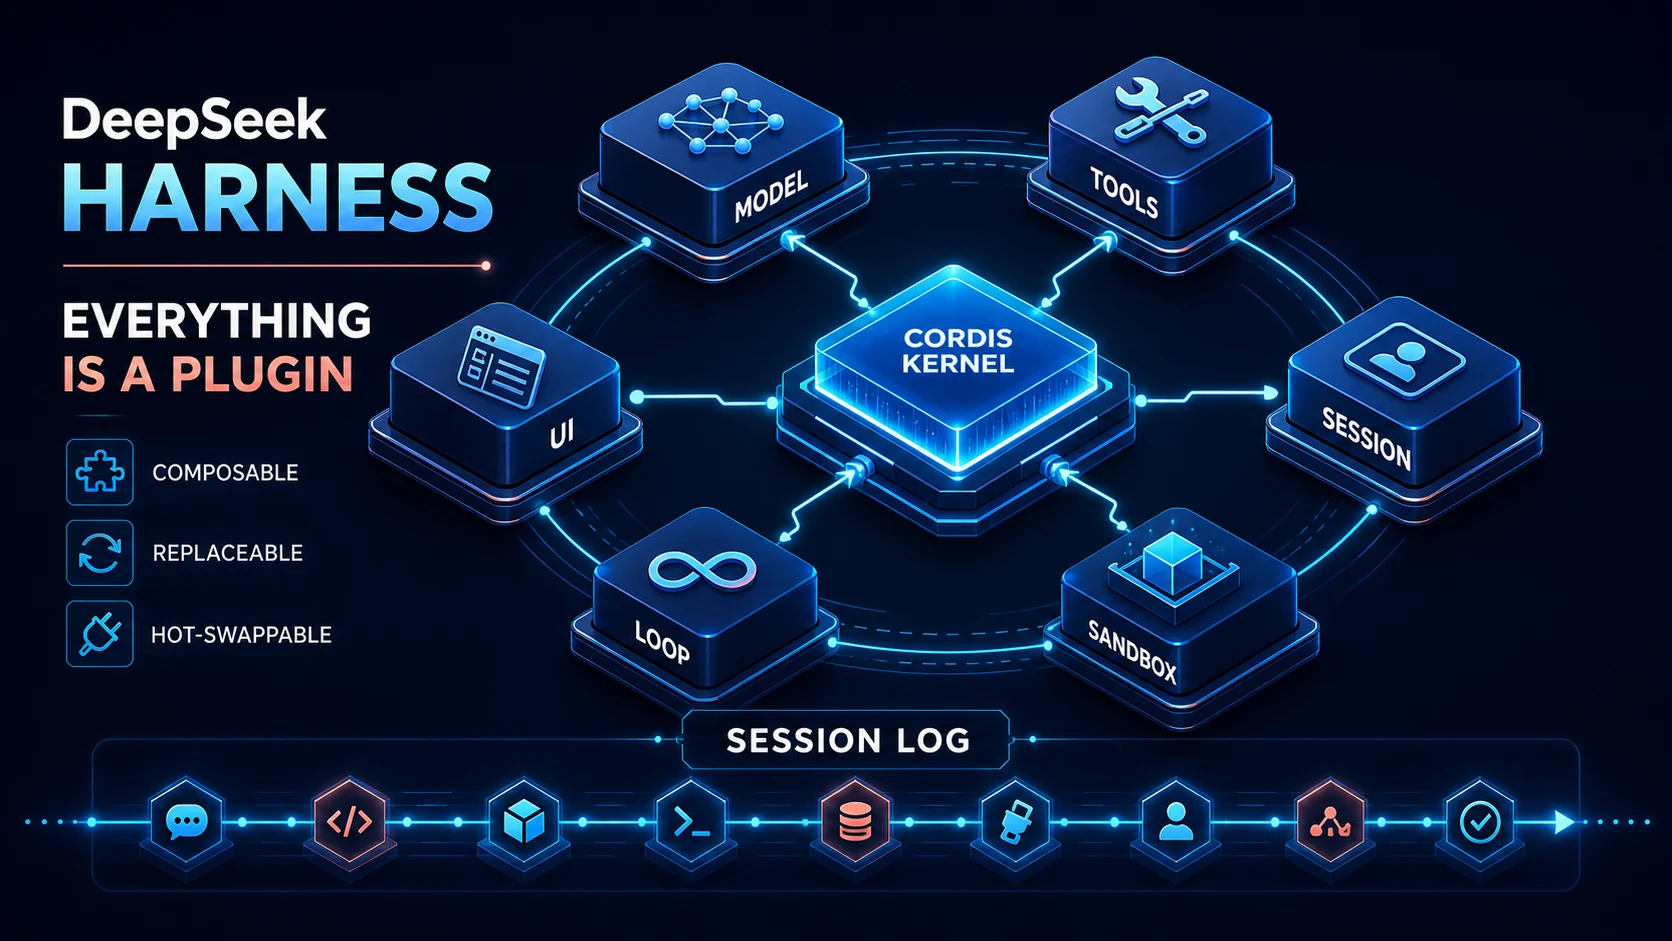
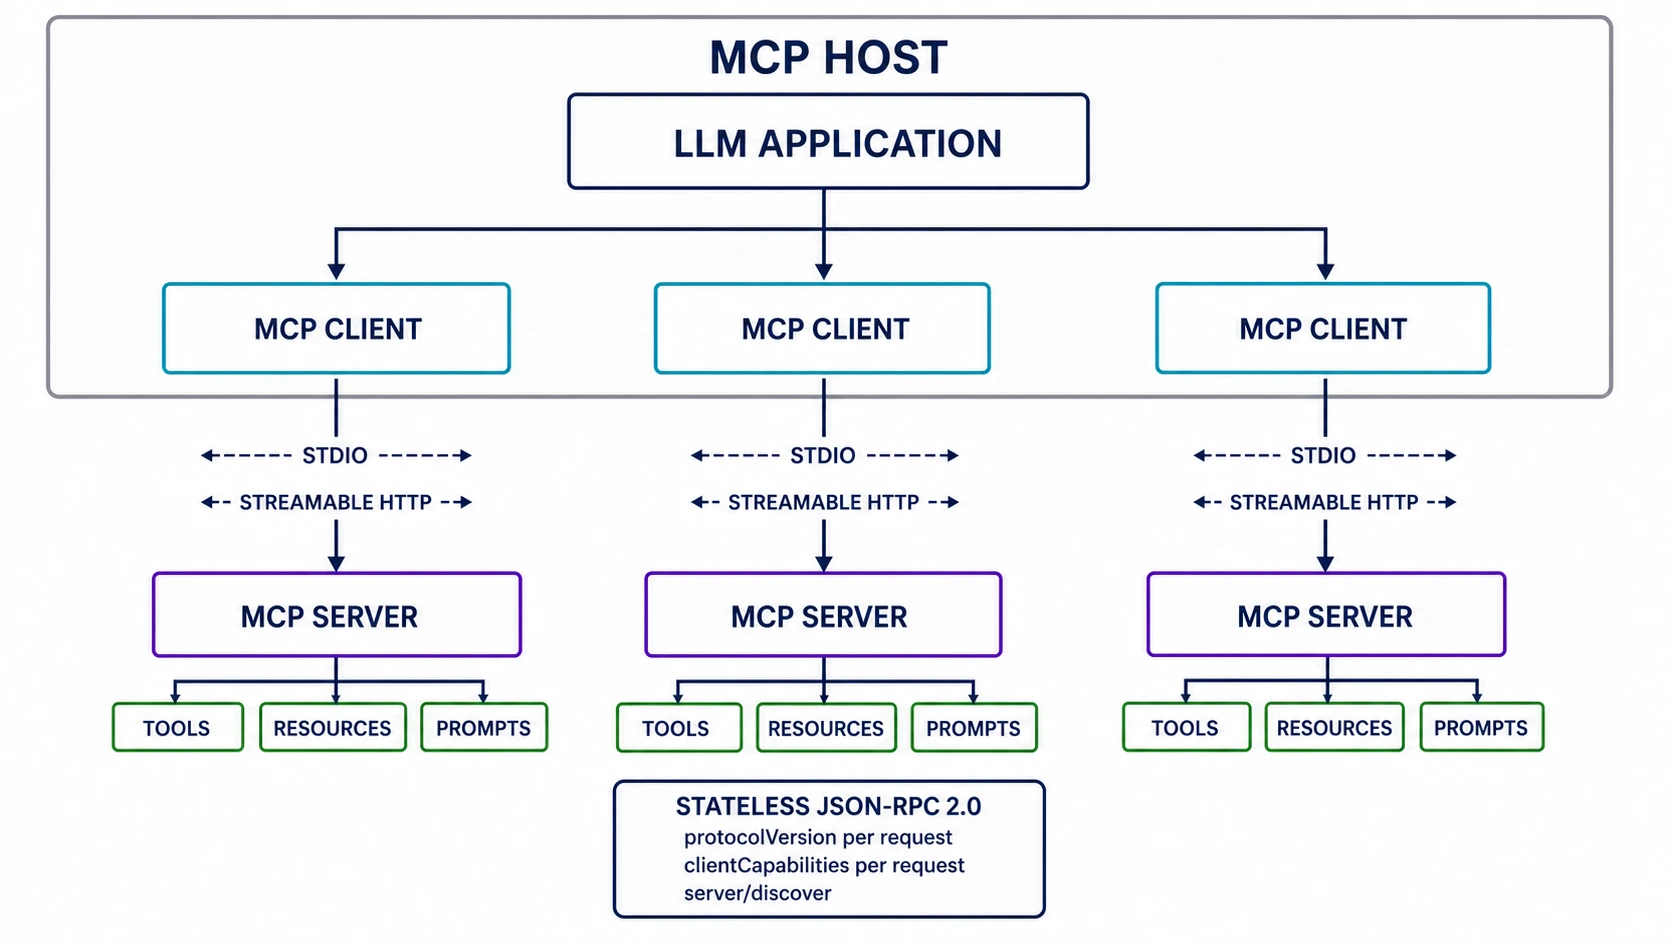
在现代软件工程中,"Harness"(原意为马具/束具)一词具有强大的双重含义。一方面,它指的是驾驭 AI 智能体(AI Agents)的基础设施——通过约束、反馈循环和任务拆分策略,将模型的原始能力转化为可靠的输出。另一方面,它是 Harness Open Source 的名字——一个集源码控制、CI/CD 流水线、开发环境和制品库于一体的端到端开发者平台。
本文将深入探讨这两个维度:从智能体 Harness 设计的概念性突破,到使用 Harness 平台的生产级 CI/CD 实战。
第一部分:什么是 Harness 工程?
马与骑手的隐喻
OpenAI 的工程团队提出了一个生动的隐喻:AI 模型就像一匹马——力量强大,但不可预测且容易跑偏。而 Harness 则是工程师围绕它构建的一切——Linter、结构化测试、文档标准、反馈循环——这些装置能够有效地引导这股力量产出成果。
在这种范式下,模型是 CPU,而 Harness 是操作系统 (OS)。CPU 负责计算,但 OS 负责文件系统、内存管理、权限控制和 I/O 调度。没有 OS 的 CPU 只是一个发热的芯片;没有 Harness 的模型只是一个产生 Token 的预测器。
工程师的主要职责正在发生转变:从编写代码转变为设计环境和构建反馈循环,从而让 AI 智能体能够可靠地运行。
— OpenAI, "Harness engineering: leveraging Codex in an agent-first world" (2026年2月)
三大支柱
Harness 工程建立在三个基本支柱之上:
| 支柱 | 含义 | 示例 |
|---|
| 上下文工程 (Context Engineering) | 确保智能体在上下文中拥有恰到好处的信息 | 压缩 (Compaction)、即时加载 (JIT)、结构化记忆 |
| 架构约束 (Architectural Constraints) | 通过机械化手段强制执行“好代码”的标准 | Linter、依赖规则、结构化测试 |
| 熵增管理 (Entropy Management) | 长期保持代码库的连贯性 | 垃圾回收、代码重构智能体 |
如果没有 Harness,即使是前沿模型产出的结果也往往是功能尚可但弱不禁风的——重复的代码、漏洞百出的核心逻辑、平庸的设计以及逐渐腐化的上下文。而通过精心设计的 Harness,同一个模型可以在 10 个冲刺(Sprint)中构建出一个拥有 16 个功能、视觉风格统一且完全可运行的应用程序。
第二部分:上下文工程——有限的资源
上下文窗口(Context Window)是智能体编程中最宝贵的资源。Anthropic 将其描述为一种收益递减的有限预算——每一个 Token 都至关重要,将无关的历史记录塞满窗口会主动降低模型的性能。
策略 1:上下文压缩 (Compaction)
压缩 (Compaction) 将完整的上下文窗口浓缩为高保真的摘要。当对话接近 Token 上限时,系统会原地总结之前的轮次,仅保留最关键的细节。
压缩前:系统提示词 + 4 轮对话 + 12 次工具调用 + 冗长的输出
        → 180K tokens (接近上限)

压缩后:压缩后的摘要:关键状态 + 当前任务 + 核心上下文
        → 30K tokens (留出更多工作空间)
虽然压缩保持了连贯性,但它并没有给智能体一个全新的开始,这意味着上下文焦虑 (Context Anxiety) 可能依然存在。
— Anthropic, "Harness design is key to performance at the frontier"
策略 2:上下文重置 (Context Reset)
上下文重置 (Context Reset) 采取了更彻底的方法:完全清空上下文窗口,启动一个新的智能体阶段(Session),并使用结构化的移交产物 (Handoff Artifact) 来承载上一个智能体的状态。
这解决了一个被称为上下文焦虑的关键失效模式——即当模型认为自己接近上下文极限时,会过早地结束工作。全新的上下文为智能体提供了一个没有累赘的清晰起点。
移交产物通常包含:
- 当前进度——哪些功能已完成,哪些正在进行中
- 文件清单——关键文件及其用途
- 后续步骤——接下来要执行的具体任务
- 已知问题——推迟处理的 Bug 或决策
策略 3:即时加载 (JIT Loading)
对于拥有数百万行代码的大型仓库,不可能将所有代码都塞进上下文。JIT 加载利用工具(如 grep、ast-grep)按需检索代码片段,并在智能体请求时将其动态注入上下文。
第三部分:被忽视的核心——结构化约束
除了上下文管理,Harness 工程中还有几个常被忽视但至关重要的概念:
1. 上下文压舱物 (Context Ballast)
智能体需要一门“通用语言”来理解项目。在仓库中加入 CLAUDE.md 或 AGENTS.md 不仅是为了人类开发者,更是为了给智能体提供压舱物 (Ballast)。
实战示例:一个典型的 CLAUDE.md 片段
# Agent 架构规范
1. **状态管理**:严禁使用 Redux。我们统一使用 Zustand 进行状态管理。
2. **样式**:所有组件必须使用 Tailwind CSS,不要创建任何 `.css` 文件。
3. **数据库**:所有数据库查询必须通过 Prisma ORM 进行,严禁直接拼接 Raw SQL。
这为智能体提供了极其清晰的操作结界,极大地减少了产生“技术债”的可能。
2. 机械化 guardrails (硬性约束)
不要指望通过 Prompt 告诉智能体“请不要在业务层写 SQL”。哪怕你在提示词中重复三遍,一旦上下文变长,它依然可能违规。
在 Harness 中,你应该配置一个 Linter 规则(例如使用 ast-grep 或 ESLint),在智能体生成代码后强制拦截:
$ npm run lint
❌ Error: [no-raw-sql] Detected Prisma raw query in src/services/user.ts:42
因为模型在面对“确凿的报错堆栈信息”时的修复能力,远远强于面对“你不应该怎么做”的软性建议时的遵循能力。这就是用程序的确定性去驾驭 LLM 的混沌性。
3. LLM-as-Auditor (审计者模式)
在生成者(Generator)输出代码后,由一个更高阶的模型(或配置了不同 System Prompt 的模型)担任 Auditor (审计者)。审计者不负责写代码,只负责在 Harness 环境中寻找逻辑漏洞和架构违规。
第四部分:多智能体协作——生成与评估的分离
近期 Harness 研究中最具影响力的见解或许是生成与评估的分离。受生成对抗网络 (GAN) 的启发,Anthropic 设计了一个三智能体系统,其表现显著优于单智能体方法。
三个角色
1. 规划者智能体 (Planner Agent)
规划者接收简单的 1-4 句话的提示词,并将其扩展为完整的产品规格说明书。它的指令是在保证雄心勃勃的范围的同时,专注于产品上下文而非细碎的技术细节。
输入: "给我做一个复古视频游戏制作器"

输出: RetroForge - 2D 复古游戏制作工具
        涵盖 10 个冲刺的 16 个功能:
        - 项目仪表盘与管理
        - 基于瓦片的地图编辑器
        - 像素画精灵编辑器
        - 可视化实体行为系统
        - 可运行的测试模式
        - AI 辅助精灵生成器
        - 音效与音乐系统
        - 带分享链接的游戏导出
        ...
关键设计决策:规划者刻意避免指定具体的颗粒化技术实现。如果它在早期就定死了技术细节且不幸定错了,这些错误会一直向下游传递。
2. 生成者智能体 (Generator Agent)
生成者按冲刺 (Sprint) 进行开发,每次实现一个功能,使用标准的技术栈(如 React + Vite + FastAPI + SQLite/PostgreSQL)。它使用 Git 进行版本控制,并在每个冲刺结束时进行自测,然后移交给 QA。
3. 评估者智能体 (Evaluator Agent)
评估者使用 Playwright MCP 像真实用户一样与运行中的程序交互——点击页面、测试 UI 功能、验证 API 端点、检查数据库状态。它从四个维度对每个冲刺进行评分:
| 准则 | 权重 | 衡量标准 |
|---|
| 设计质量 | 高 | 它感觉像是一个连贯的整体,还是零散部件的堆砌? |
| 原创性 | 高 | 是否有刻意的创意选择,还是仅仅是模板默认值? |
| 工艺 (Craft) | 正常 | 排版层级、间距、色彩和谐度、对比度 |
| 功能性 | 正常 | 用户能否理解界面并完成任务? |
每个维度都有一个硬性门槛——如果任何一个低于门槛,该冲刺即宣告失败,生成者将收到详细的反馈意见。
冲刺合同谈判
在每个冲刺开始前,生成者和评估者会协商一份合同:在编写任何代码之前,它们会对“完成”的定义达成一致——即具体的、可测试的行为和验收标准。这弥合了高层用户故事与可验证实现之间的鸿沟。
自我评估的困境
一个关键洞察:当要求智能体评估自己的工作时,它们会习惯性地倾向于给出正面评价——将平庸的输出美化为优秀。将评估者从生成者中分离出来,使得调节怀疑精神变得更加容易:
同一智能体(自我评估):
  "设计简洁且功能齐全。评分:9/10" ← 过度宽容

独立的评估者(调优为怀疑立场):
  "布局使用了固定高度的面板,浪费了空间。工作流过于呆板
   ——没有任何指引告知用户在填充关卡前应先创建精灵。
   核心游戏逻辑对输入无响应。评分:4/10" ← 诚实的评估
真实结果对比
| 指标 | 单个智能体 | 3 智能体 Harness |
|---|
| 成本 | $6 | $124 |
| 耗时 | 30 分钟 | 4 小时 |
| 功能实现 | 部分完成(核心逻辑断裂) | 16 个功能全量完成(运行正常) |
| 运行模式 | 无法运行 | 具有物理效果的可玩模式 |
| 设计连贯性 | 通用模板 | 一致的视觉身份 |
虽然 Harness 的成本高出 20 倍,但产出质量的差距是惊人的:单智能体跑出来的游戏完全无法运行——实体显示在屏幕上但对输入毫无反应。而 Harness 运行产出了一个具有物理效果、AI 辅助精灵生成和连贯设计语言的可玩游戏。
第五部分:Harness 开源平台概述
除了“作为智能体基础设施的 Harness”这一概念外,还有一个具体的开源平台也叫 Harness——它是传说中的 Drone CI 的下一代演进。
什么是 Harness 开源平台?
Harness Open Source 是一个端到端的开发者平台,集成了四大模块:
| 模块 | 描述 | 关键特性 |
|---|
| 源码控制 (Source Control) | 基于 Git 的代码托管 | 仓库、PR、代码审查、分支保护 |
| CI/CD 流水线 | 自动化构建与部署 | 基于 Docker 的步骤、YAML 配置、并行执行 |
| Gitspaces | 托管的开发环境 | 云原生工作区、秒级启动 |
| 制品库 (Artifact Registry) | 包管理 | 支持 Docker、Maven、npm 制品 |
Drone 的遗产
Harness 代表了对下一代 Drone 的巨大投入。Drone 仅专注于持续集成,而 Harness 增加了源码托管、开发环境和制品仓库——为团队提供了一个完整的开源 DevOps 平台。
Drone 的代码库目前作为一个功能分支继续存在,供那些在迁移期间仍需其特定流水线能力的用户使用。
技术架构
- 后端:Go 语言编写,单二进制部署
- 数据库:开发环境使用 SQLite,生产环境使用 PostgreSQL
- 前端:基于 React 的 Web UI
- 流水线:在 Docker 容器内执行
- API:提供完整的 REST API 和 Swagger 文档
第六部分:实战——部署 Harness 并构建 CI/CD 流水线
第一步:使用 Docker 部署 Harness
运行 Harness 只需要一条命令:
docker run -d \
  -p 3000:3000 \
  -p 3022:3022 \
  -v /var/run/docker.sock:/var/run/docker.sock \
  -v /tmp/harness:/data \
  --name harness \
  --restart always \
  harness/harness
容器启动后,在浏览器中访问 http://localhost:3000。
重要提示:-v /tmp/harness:/data 挂载卷是必不可少的。如果没有它,当容器停止时,所有的仓库和配置都会丢失。生产环境请使用命名卷或持久化目录。
第二步:初始设置
- 创建管理员账号——首次访问时,系统会提示你创建初始管理员(默认:
admin / changeit)
- 生成 PAT (个人访问令牌) 用于 API 访问:
./gitness login
./gitness user pat "my-pat-uid" 2592000
- 测试 API:
curl http://localhost:3000/api/v1/user \
  -H "Authorization: Bearer $TOKEN"
第三步:创建仓库
进入 Web 界面并创建一个新仓库。Harness 提供完整的 Git 托管功能,包括:
- 分支保护规则
- Pull Request 开发流
- 代码审查与评论
- Webhook 集成
第四步:配置 CI/CD 流水线
在你的仓库根目录下创建 .harness/ 目录,并添加一个流水线配置文件:
kind: pipeline
spec:
stages:
- type: ci
spec:
steps:
- name: clone
type: run
spec:
container: alpine/git
script: |
git clone $REPO_URL .
echo "✅ 克隆完成"
- name: install
type: run
spec:
container: node:20-alpine
script: |
npm ci
echo "✅ 依赖安装完成"
- name: build
type: run
spec:
container: node:20-alpine
script: |
npm run build
echo "✅ 构建成功"
- name: test
type: run
spec:
container: node:20-alpine
script: |
npm run test -- --coverage
echo "✅ 单元测试全量通过"
- name: agent-qa-eval
type: run
spec:
container: python:3.11-alpine
script: |
pip install deepeval
echo "🤖 启动评估者智能体进行架构审查..."
deepeval test run tests/architecture_audit.py
echo "✅ 架构合规性扫描通过"
- name: docker-build
type: plugin
spec:
name: docker
inputs:
repo: myregistry/myapp
tags: latest,${DRONE_COMMIT_SHA:0:8}
dockerfile: Dockerfile
第五步:流水线触发器
Harness 支持自动流水线触发:
trigger:
branch:
- main
event:
- push
- pull_request
每次向 main 分支执行 git push 时,系统将自动执行:
- 克隆仓库
- 安装依赖
- 构建项目
- 运行测试并统计覆盖率
- 构建并推送 Docker 镜像
第六步:流水线的 Docker 配置
Harness 流水线在 Docker 容器内运行。应用程序会自动与你的守护进程协商 Docker API 版本。
针对非标准的 Docker 运行时:
sudo ln -sf ~/.rd/docker.sock /var/run/docker.sock
sudo ln -sf ~/.colima/default/docker.sock /var/run/docker.sock
GITNESS_DOCKER_HOST=unix:///Users/<username>/.rd/docker.sock
第七步:从源码构建(进阶)
对于贡献者或想要尝试最新功能的用户:
go install google.golang.org/protobuf/cmd/protoc-gen-go@v1.28.1
go install google.golang.org/grpc/cmd/protoc-gen-go-grpc@v1.2.0
make dep
make tools
pushd web && yarn install && yarn build && popd
make build
./gitness server .local.env
第八步:访问 Swagger API
Harness 提供了详尽的 API 文档:
- 主 API:
http://localhost:3000/swagger
- OpenAPI 规格书:
http://localhost:3000/openapi.yaml
- 制品库 API:
http://localhost:3000/registry/swagger/
你可以自动生成 UI 所使用的客户端代码:
./gitness swagger > web/src/services/code/swagger.yaml
cd web && yarn services
第七部分:连接两个世界——智能体 Harness + 平台 Harness
"Harness" 的两种含义——智能体基础设施与 DevOps 平台——正在合流。请设想一个现代 AI 驱动的开发工作流架构:
闭环流程
- 智能体 Harness 通过“规划者 → 生成者 → 评估者”循环生成高质量代码。
- CI/CD 集成:将此测试放入 Harness CI 的步骤中。当 Agent 生成代码或内容后,自动触发评估,只有通过阈值的 PR 才能合并。
如何使用 Aider 构建你的 Harness?
Aider 是目前最接近“Harness 工程”落地且高 Start (22k+) 的工具。它不仅是一个命令行聊天机器人,更是一个利用 Git 自动管理 Harness 的“协同工程师”。
实战步骤:
-
自动上下文映射:Aider 启动时会读取 .gitignore,并根据你的文件树生成 REPOMAP(仓库地图)。这本质上是 JIT Loading。
-
Git 原子化提交:每当 Aider 完成一个功能的修改并运行测试后,它会自动进行 Git 提交。这为智能体提供了一个可回退的阶段检查点。
-
内置测试 Harness:
aider --test "npm test" src/payment.ts
如果测试失败,Aider 会自动分析报错,尝试修复并重新运行测试,直到通过为止。这就是典型的反馈循环 (Feedback Loop)。
-
Git 提交将批准后的代码推送到 Harness 托管的仓库。
-
Harness 流水线自动执行构建、测试和部署。
-
监控与反馈流回系统,启发下一轮迭代。
这就是未来:AI 智能体不仅仅是在写代码,而是通过真实的 CI/CD 流水线交付生产级软件。
Aider 与 Agent 框架的定位对比
在实践中,我们需要区分交互式编码辅助与系统级 Agent 框架:
| 特性维度 | Aider (终端交互统帅) | OpenHarness (系统指挥官) |
|---|
| 主要使用者 | 人类开发者(终端交互) | 系统/微服务(API/脚本驱动) |
| 上下文形态 | 基于 JIT / .gitignore 动态抓取 | CLAUDE.md + 会话记忆归档 |
| 回退机制 | 依赖 Git 本地提交流 | 多节点流式循环(API Retry) |
| 典型应用场景 | 快速实现单个 Feature、本地 Debug | 搭建自动评估管线、后台群体协作 |
第八部分:行业标杆——OpenHarness 开源框架
在所有的开源尝试中,OpenHarness (oh) 是一个值得深入研究的范本。它由 HKUDS 团队开发,旨在提供一个工业级的、与模型无关的智能体驾驭层。
OpenHarness 的设计完全印证了我们之前讨论的“Harness 即 OS”的观点。它的核心架构由五个关键维度组成:
1. 强化的 Agent Loop
不同于简单的“提示-回复”循环,OpenHarness 实现了流式工具调用循环 (Streaming Tool-Call Cycle)。它支持:
- 并行工具执行:同时启动多个 Shell 或 Search 任务。
- 指数退避重试:自动处理 API 速率限制和网络抖动。
- 消耗追踪:实时计算 Token 成本,防止智能体陷入无限递归导致的账单爆炸。
OpenHarness 内置了 43 个核心工具,涵盖文件操作、Shell 执行、Web 搜索和 MCP(Model Context Protocol)支持。其最独特之处在于:
- 按需加载 Skill:通过读取
.md 文档,智能体可以即时学会如何操作特定的内部系统。
- 插件生态:支持钩子(Hooks)和自定义智能体注入。
3. 记忆与上下文管理
它原生支持 CLAUDE.md 发现机制,将项目规范自动注入初始上下文。同时:
- Auto-Compaction:当长对话接近窗口上限时,自动触发总结。
- MEMORY.md:将关键决策和进度持久化到磁盘,支持跨 Session 的记忆继承。
4. 治理与权限 (Governance)
这是 OpenHarness 区别于简单的“实验脚本”的关键:
- 多层级权限:可以配置只读、受限写入或完全控制。
- 交互式审批:在执行
rm -rf 或危险 Shell 命令前,弹出对话框请求人类确认。
5. 群体协同 (Swarm)
支持 Subagent Spawning。主智能体可以将子任务委派给专门的子智能体(如“文档专家”或“单元测试生成器”),实现高度并发的任务处理。
核心亮点:代码即 Harness (实战演示)
为了感受这种框架的力量,看看我们如何用 OpenHarness 启动一个带审批流的智能体会话:
from openharness import Agent, ToolRegistry, Memory
tools = ToolRegistry.load(["shell", "file_system", "mcp_playwright"])
memory = Memory.load_from("MEMORY.md")
agent = Agent(
model="claude-3-5-sonnet",
tools=tools,
memory=memory,
governance={
"require_human_approval": ["shell.exec(rm*)", "shell.exec(docker*)"]
}
)
for step in agent.run("重构项目数据库层,并运行测试"):
if step.type == "tool_call":
print(f"[{step.tool}] 执行中...")
elif step.type == "approval_required":
user_input = input(f"智能体试图执行 {step.command},是否允许?(y/n)")
step.approve(user_input == 'y')
与直接调用 OpenAI 或 Anthropic 的 API 相比,OpenHarness 将开发者从繁琐的 Token 截断、工具执行状态机、报错重试逻辑中彻底解放了出来。
第九部分:最佳实践与经验教训
关于智能体 Harness 设计
-
寻找最简单的方案,仅在必要时增加复杂度。 Harness 中的每一个组件都编码了你对模型能力的负面假设——而随着模型进步,这些假设往往会失效。
-
当新模型发布时,重新审视你的 Harness。 移除那些不再起支撑作用的部件,添加以前无法实现的新能力。Anthropic 团队在从 Opus 4.5 升级到 4.6 时移除了冲刺拆分逻辑,因为新模型能够原生处理长时间的连贯会话。
-
独立调优评估者。 让一个独立的评估者保持怀疑态度立场的难度,远低于让生成者对自己代码进行批判。
-
当观察到“上下文焦虑”时,优先选择上下文重置而非压缩。 清洁的起点往往比总结后的持续更可靠。
-
有趣的 Harness 空间并不会随模型进步而萎缩——它在迁移。 AI 工程师的乐趣在于不断发现新的组合方式。
关于 Harness 平台部署
- 生产环境务必使用持久化卷 (
-v /persistent/path:/data)。
- 多用户环境使用 PostgreSQL 替代 SQLite。
- 配置 Webhook 密钥以确保流水线触发的安全性。
- 设置分支保护规则,防止直接向
main 分支推送代码。
- 使用 REST API 进行编排式管理与集成。
"Harness 工程" 代表了我们思考 AI 辅助软件开发的根本性转变。它不再仅仅是给模型一个提示并寄希望于最好的结果——而是关于设计环境、约束和反馈循环,从而有系统地引导 AI 智能体走向高质量、生产级的产出。
无论你是在构建能够自主交付全栈应用的多智能体系统,还是在部署自托管的 CI/CD 平台来自动化团队的工作流,其核心准则是通用的:AI 周边的基础设施与 AI 本身同样重要。
马很有力,而 Harness 让它变得有用。
参考资料